Indhold
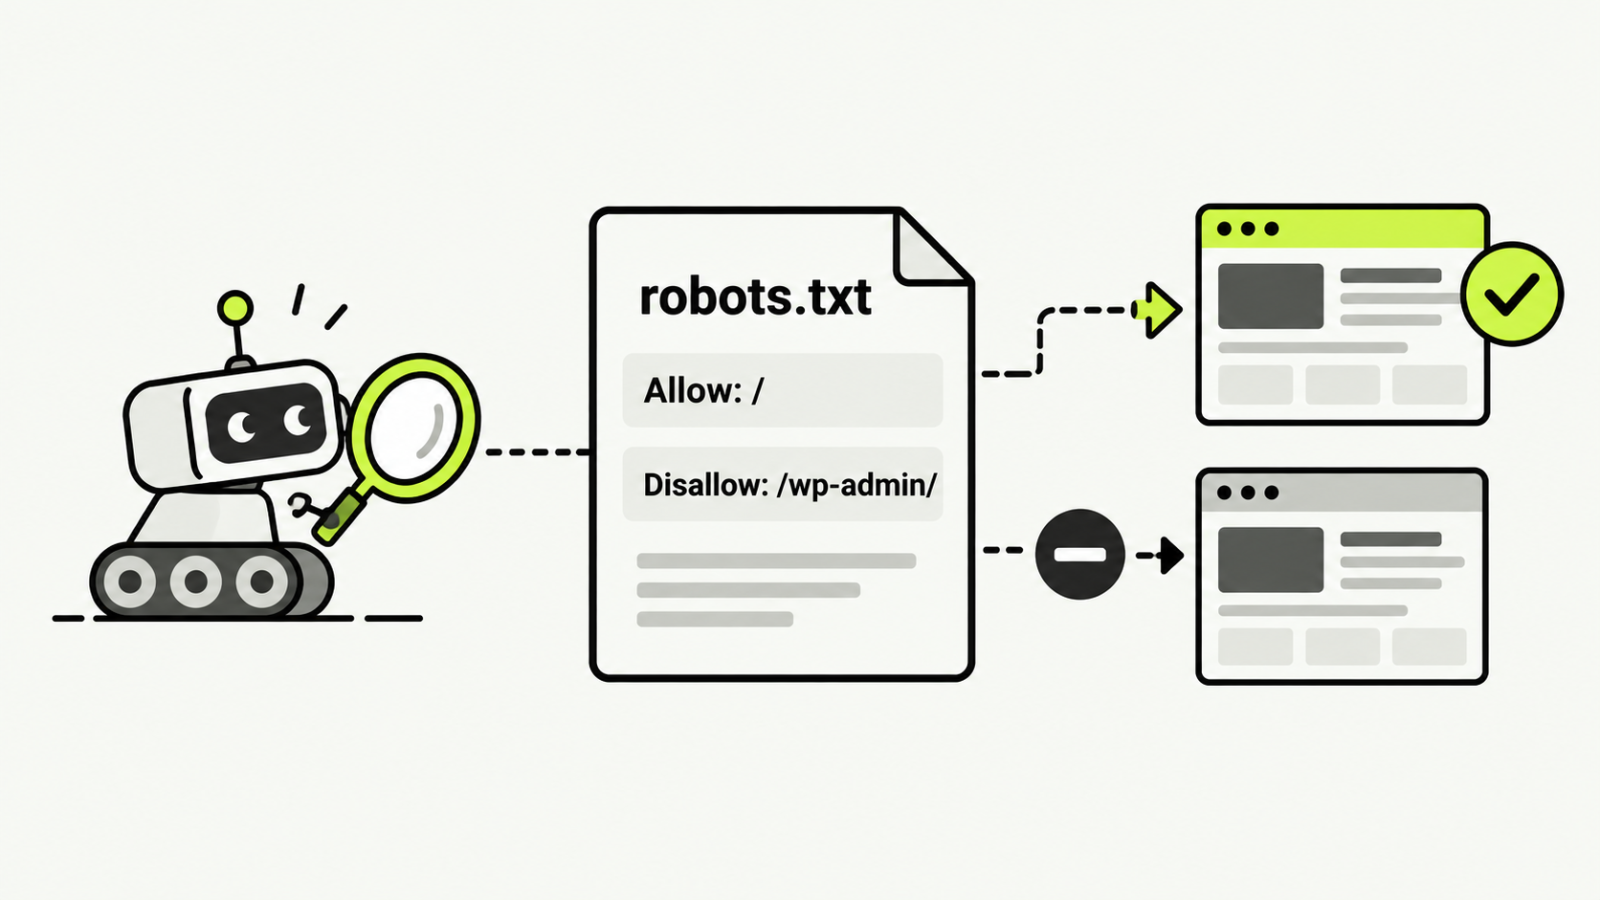
AI-tjenesterne henter jeres sider med deres egne crawlere, og de fleste af dem kan styres i robots.txt ligesom Googlebot. Forskellen er, at der er to slags: dem, der henter til træning af modellerne, og dem, der henter for at svare på et spørgsmål her og nu. Spærrer I for den forkerte, er I usynlige i AI-svar uden at vide det.
Her er de crawlere, der betyder noget, hvad hver af dem bruges til, og hvordan I sætter robots.txt op efter det, I faktisk vil. Hvorfor det er værd at være med, står i GEO-introduktionen.
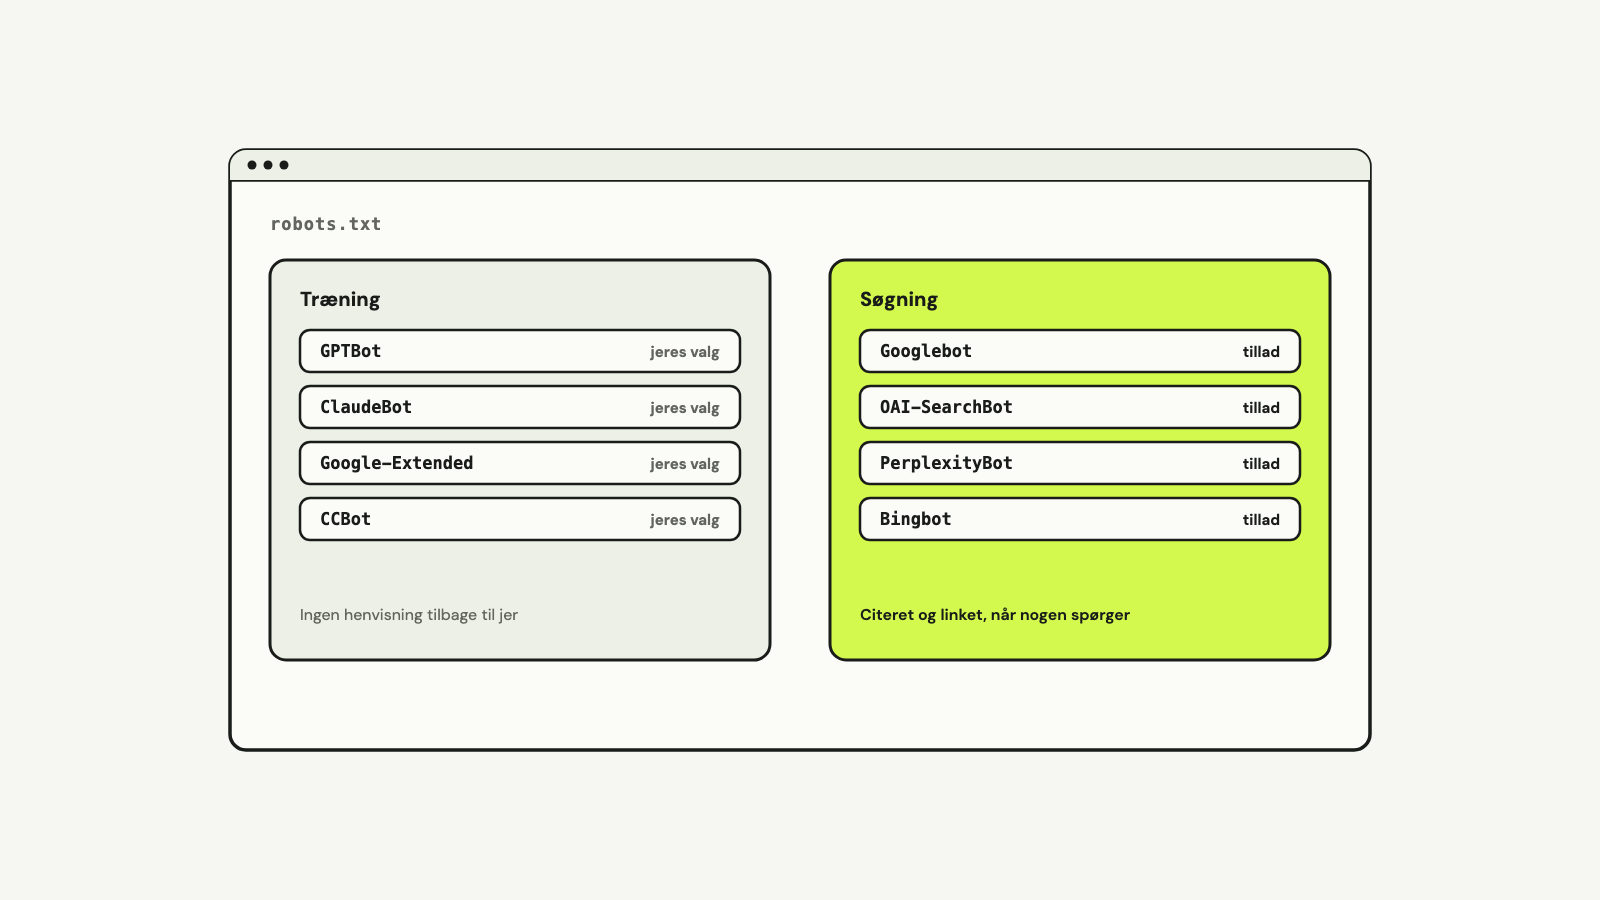
To slags hentning
Træning er, når en udbyder henter store mængder sider for at bygge selve modellen. Det sker løbende, det giver ingen henvisning tilbage til jer, og modellen husker ikke, hvor en sætning kom fra.
Søgning er, når en tjeneste henter sider, fordi en bruger lige har stillet et spørgsmål. Her bliver jeres side læst, citeret og linket til. Det er den hentning, GEO handler om.
De store udbydere har adskilt de to med hver sin crawler. Det betyder, at I kan sige nej til træning og ja til søgning. Mange sites spærrede for alt AI i 2023 og 2024, før de fleste søgecrawlere fandtes, og har aldrig åbnet igen. Det er den første ting, I skal kontrollere.
Desuden henter ChatGPT-User, Claude-User og Perplexity-User en side, når en bruger beder om det. OpenAI skriver, at robots.txt måske ikke gælder for den slags hentning, fordi brugeren har sat den i gang, og Perplexity skriver, at Perplexity-User generelt ignorerer robots.txt.
Crawlerne, der betyder noget
| Crawler | Udbyder | Bruges til | Anbefaling |
|---|---|---|---|
Googlebot |
Søgning, AI-oversigter og AI-tilstand | Tillad. Spærrer I den, er I ude af Google. AI-funktionerne kan fravælges særskilt i Search Console. | |
Google-Extended |
Token, ikke crawler. Styrer træning og grounding af Gemini. Påvirker ikke søgning eller AI-oversigter. | Jeres valg. Ingen effekt på synlighed i Google Søgning. | |
OAI-SearchBot |
OpenAI | Søgning i ChatGPT med kildehenvisning | Tillad, hvis I vil citeres i ChatGPT. |
ChatGPT-User |
OpenAI | Henter en side, når en bruger beder om det. Bruges ikke til at afgøre, om I vises i søgning. | Tillad. |
GPTBot |
OpenAI | Træning | Jeres valg. |
PerplexityBot |
Perplexity | Søgning med kildehenvisning. Bruges ikke til træning. | Tillad, hvis I vil citeres i Perplexity. |
Perplexity-User |
Perplexity | Henter en side, når en bruger spørger | Tillad. |
Bingbot |
Microsoft | Bing-søgning og Copilot | Tillad. Copilot bygger på Bings indeks. |
ClaudeBot |
Anthropic | Træning | Jeres valg. |
Claude-SearchBot |
Anthropic | Indeksering til søgning i Claude | Tillad, hvis I vil citeres i Claude. |
Claude-User |
Anthropic | Henter en side, når en bruger spørger | Tillad. |
Applebot-Extended |
Apple | Token, ikke crawler. Styrer træning af Apples modeller. Applebot selv er søgning i Siri, Spotlight og Safari. | Jeres valg. |
CCBot |
Common Crawl | Åbent datasæt, som mange modeller trænes på | Jeres valg. |
Navnene og formålene kan ændre sig, så slå op hos udbyderne selv, ikke i en liste fra et plugin. OpenAI har sin på developers.openai.com, Google har sin på Google Crawling Infrastructure, og Anthropic, Perplexity, Apple og Common Crawl har deres egne.
Sådan ser en fornuftig robots.txt ud
For de fleste virksomheder er svaret: ja til alt, der citerer, og et bevidst valg om træning. Et eksempel, der siger nej til træning og ja til søgning:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://jeresdomæne.dk/sitemap_index.xml
Søgecrawlerne, OAI-SearchBot, PerplexityBot, Claude-SearchBot og Bingbot, er ikke nævnt og falder derfor ind under User-agent: *, som tillader alt undtagen admin. Det er pointen: Det, I ikke spærrer, er åbent.
En crawler følger kun User-agent: *, hvis ingen gruppe nævner den ved navn. Giver I en crawler sin egen gruppe, skal alle dens regler stå der.
Vil I hellere sige ja til træning også, så slet de tre første blokke. Der er argumenter for det: En model, der er trænet på jeres tekster, kender jeres navn og jeres måde at forklare på. Der er også argumenter imod. Det er en forretningsbeslutning, ikke en teknisk. Vær opmærksom på, at Google-Extended ikke holder jer ude af Googles AI-oversigter. Det gør indstillingen for generativ AI i Search Console eller nosnippet, og begge dele koster jer synlighed.
Det, der spærrer uden robots.txt
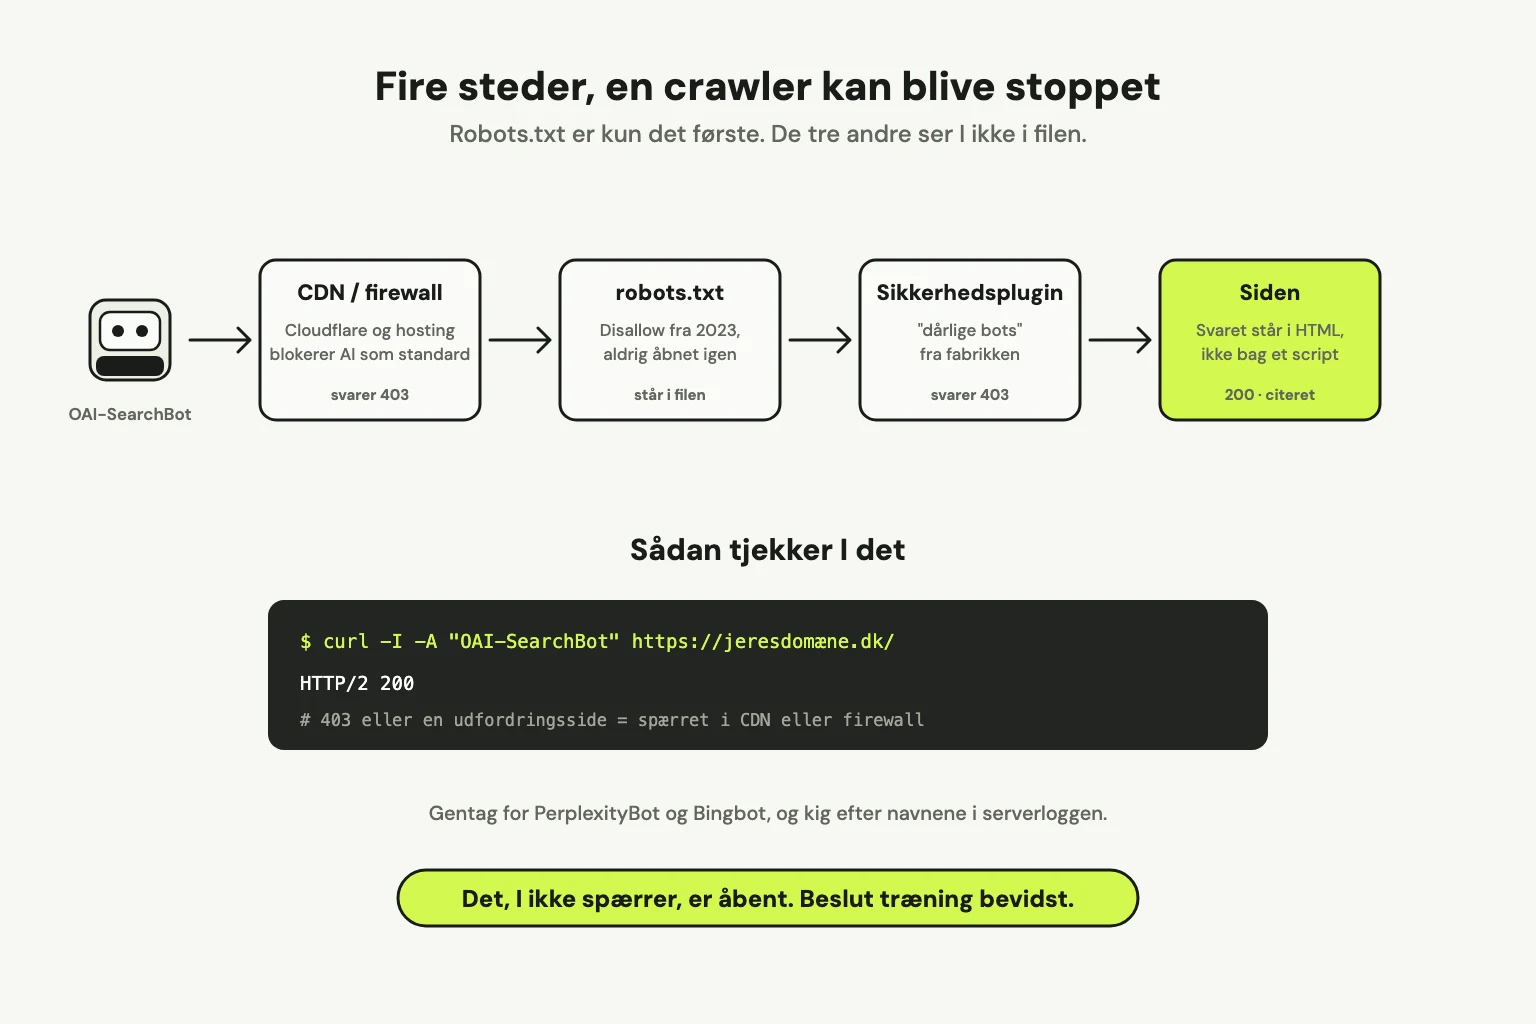
Robots.txt er ikke det eneste sted, en crawler kan blive stoppet. Tre ting rammer oftere, end man tror:
- CDN og firewall. Cloudflare skiftede i juli 2025 til at blokere AI-crawlere som standard, og nye domæner bliver spurgt ved oprettelsen, om AI-crawlere skal have adgang. Nogle webhoteller har tilsvarende regler i deres firewall. Spærringen står ikke i jeres robots.txt. Svarer serveren 403 til
OAI-SearchBot, er I spærret, uanset hvad filen siger. - Sikkerhedsplugins. Plugins, der blokerer “dårlige bots”, har ofte AI-crawlere på listen fra fabrikken.
- Indhold, der kræver JavaScript. Google kører JavaScript, men Vercel og MERJ fandt i en analyse fra december 2024, at ingen af de store AI-crawlere gjorde det. Tekst, der først tegnes af et script, findes ikke for dem. Det er samme krav som under semantisk HTML.
Sådan kontrollerer I det
- Åbn
jeresdomæne.dk/robots.txt, og læs hver blok. Notér, hvilke crawlere der er spærret, og om det er med vilje. - Kontrollér serverens svar for søgecrawlerne. Det kan gøres med en forespørgsel, hvor user-agent er sat til fx
OAI-SearchBot. Svarer serveren 200, er vejen sandsynligvis åben. Svarer den 403 eller en udfordringsside, er det CDN eller firewall. Men et CDN kan behandle et lånt navn anderledes end den rigtige crawler, så 200 er et godt tegn, ikke et bevis. - Kig i serverloggen eller CDN’ets statistik efter de samme navne. Ser I aldrig
OAI-SearchBot,PerplexityBotellerClaude-SearchBot, bliver I ikke hentet, og så bliver I heller ikke citeret. - Kontrollér, at jeres vigtigste svar står i HTML’en og ikke bag et script.
- Gentag kontrollen, når I skifter hosting, CDN eller sikkerhedsplugin. Det er dér, spærringer opstår.
Robots.txt afgør ikke, om I bliver citeret. Den afgør kun, om I kan blive det. Resten handler om, hvad der står på siden, og det står under skriv, så en AI kan citere jer. Hvordan vi gennemgår det for jer, står under GEO-optimering.
Kilder
- OpenAI, Overview of OpenAI Crawlers, developers.openai.com.
- Google, List of Google’s common crawlers, developers.google.com.
- Search Console Help, Search generative AI control, support.google.com.
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?, support.claude.com.
- Perplexity, Perplexity Crawlers, docs.perplexity.ai.
- Apple, About Applebot, support.apple.com.
- Common Crawl, CCBot, commoncrawl.org.
- IETF, RFC 9309: Robots Exclusion Protocol, rfc-editor.org.
- Cloudflare, Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large, cloudflare.com.
- Vercel og MERJ, The rise of the AI crawler, vercel.com.