Indhold
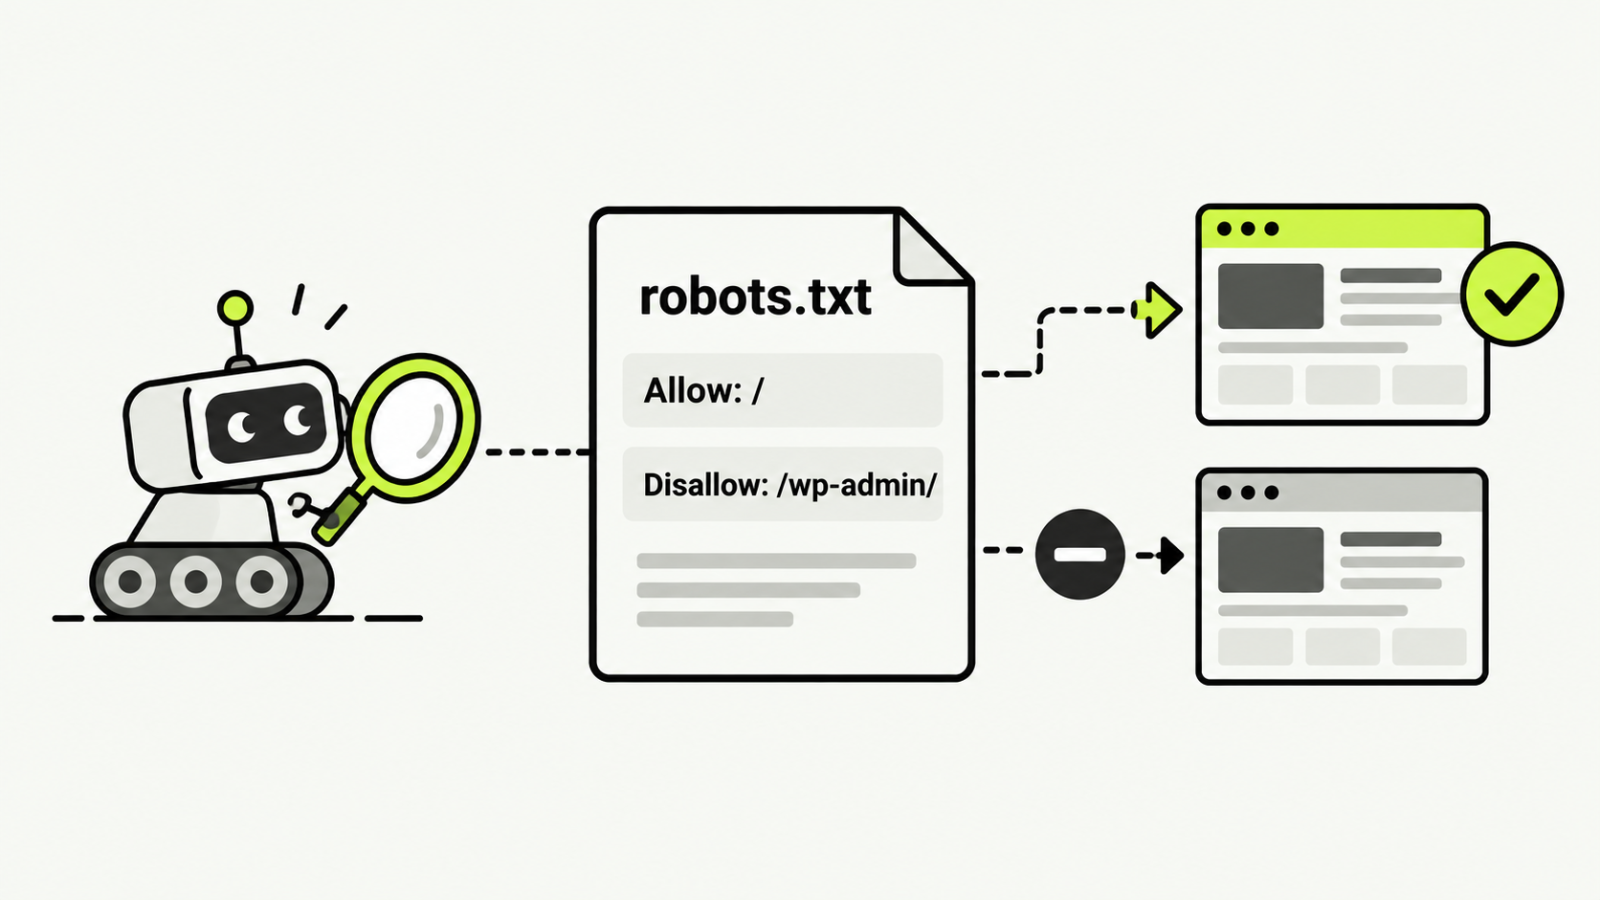
En robots.txt er en fil i roden af sitet, på /robots.txt. Den siger, hvilke adresser en crawler ikke skal hente. Formatet blev standardiseret i 2022 som RFC 9309, og standarden skriver selv, at reglerne ikke er en form for adgangskontrol.
Filen gælder ét sted. https og http er hver sin fil. www og uden www er hver sin fil. En spærring på den ene gælder ikke den anden.
Eksempel
User-agent er den crawler, reglen gælder. Stjernen er alle, der ikke har deres egen gruppe. Disallow er stien, der ikke skal hentes. Allow er en undtagelse. Google bruger den mere specifikke linje:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
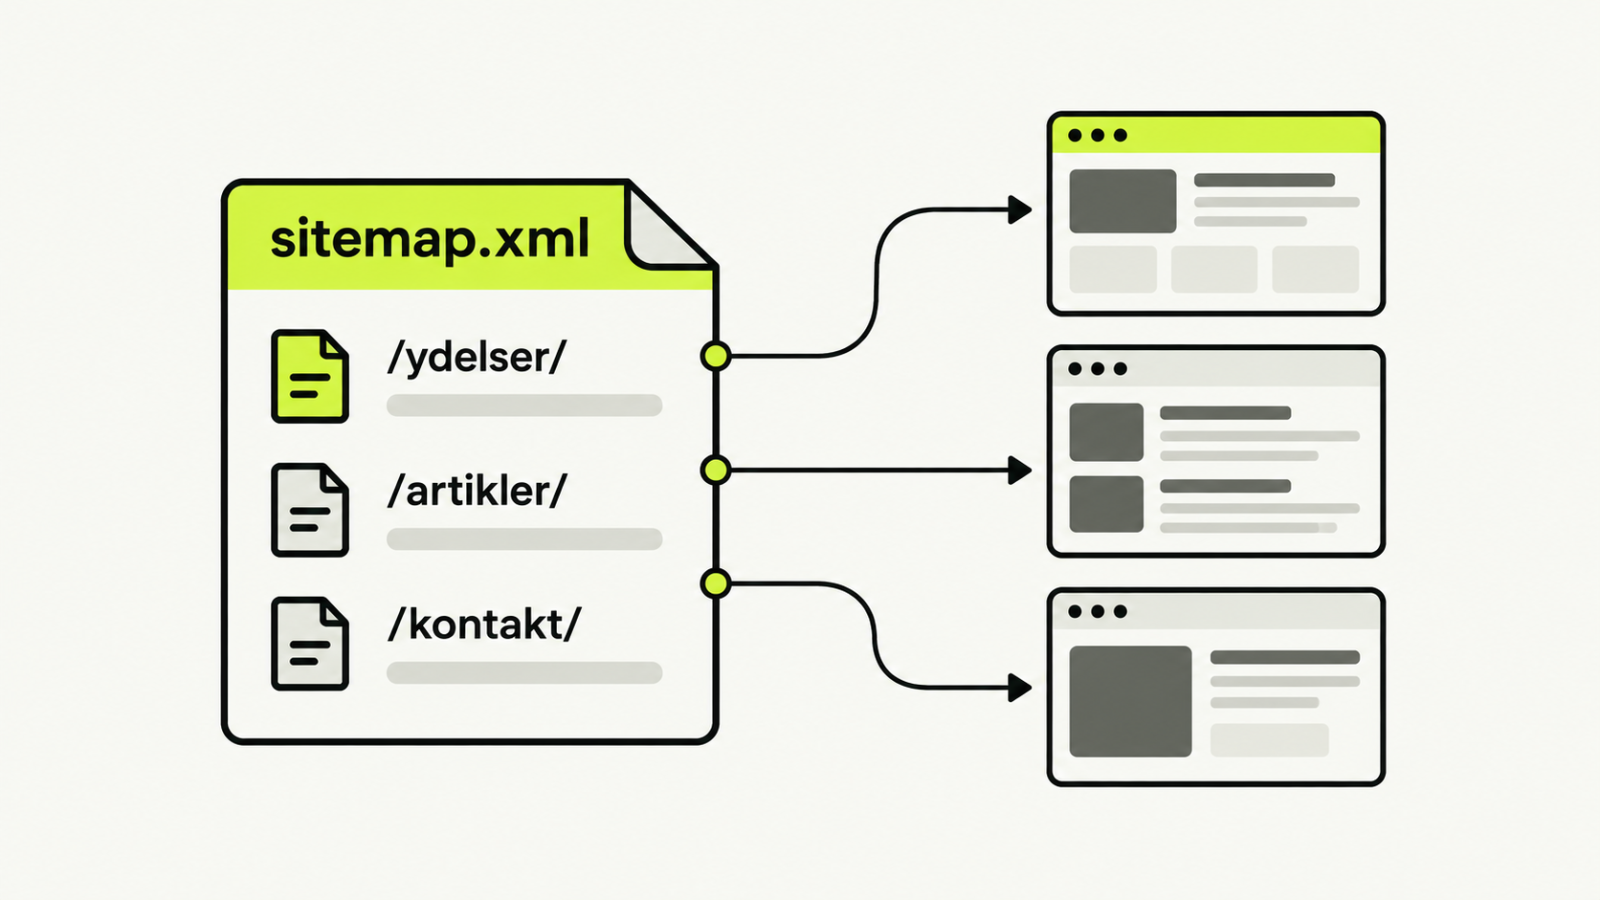
Eksemplet begrænser crawl af wp-admin, men tillader den mere specifikke admin-ajax.php-adresse. Det beskytter ikke administrationen mod adgang. En valgfri Sitemap-linje kan desuden pege på jeres XML-sitemap.
Hvad der skal spærres
Admin, intern søgning og andre adresser, der ikke er sider, I vil findes på. Disallow: /?s= holder søgeresultaterne ude af crawlen. De er de samme indlæg i en ny rækkefølge.
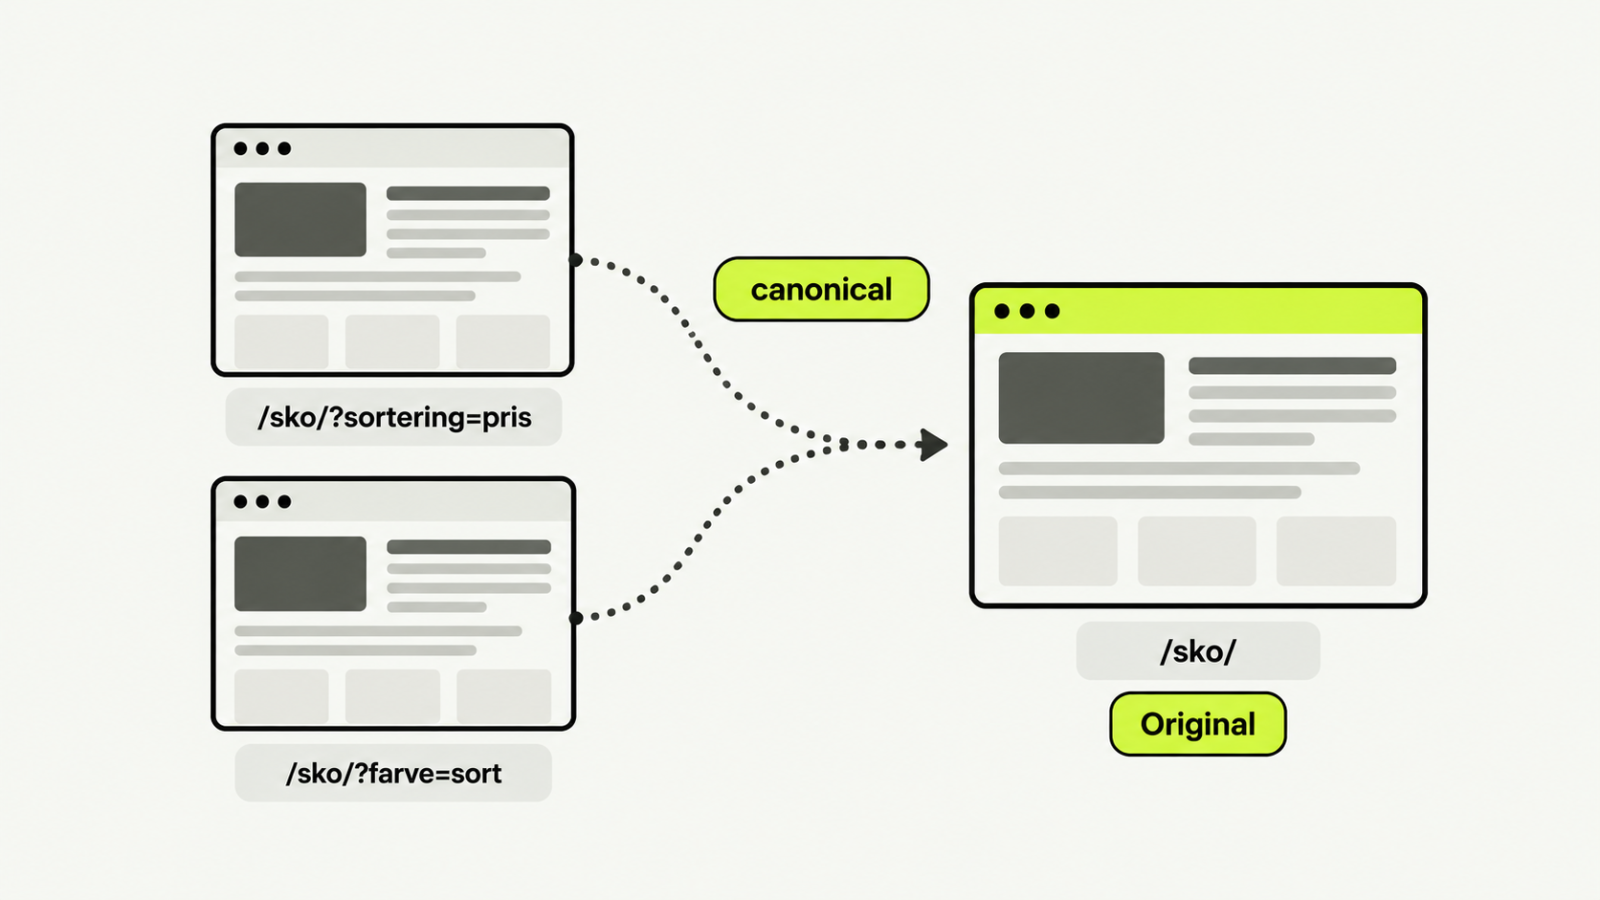
Et filter, hvis canonical skal læses, skal ikke spærres. Google kan ikke se tagget på en adresse, filen har blokeret. Beskeden i canonical-tagget når kun frem, hvis siden bliver hentet.
Hvad der ikke skal spærres
Spær ikke CSS, JavaScript eller billeder, som Google behøver for at gengive og forstå siden. Ressourcer, der ikke er nødvendige, kan vurderes særskilt.
Sider, I vil findes på. En Disallow: / efterladt fra udviklingen spærrer hele sitet. Den skal væk, før siden lægges online.
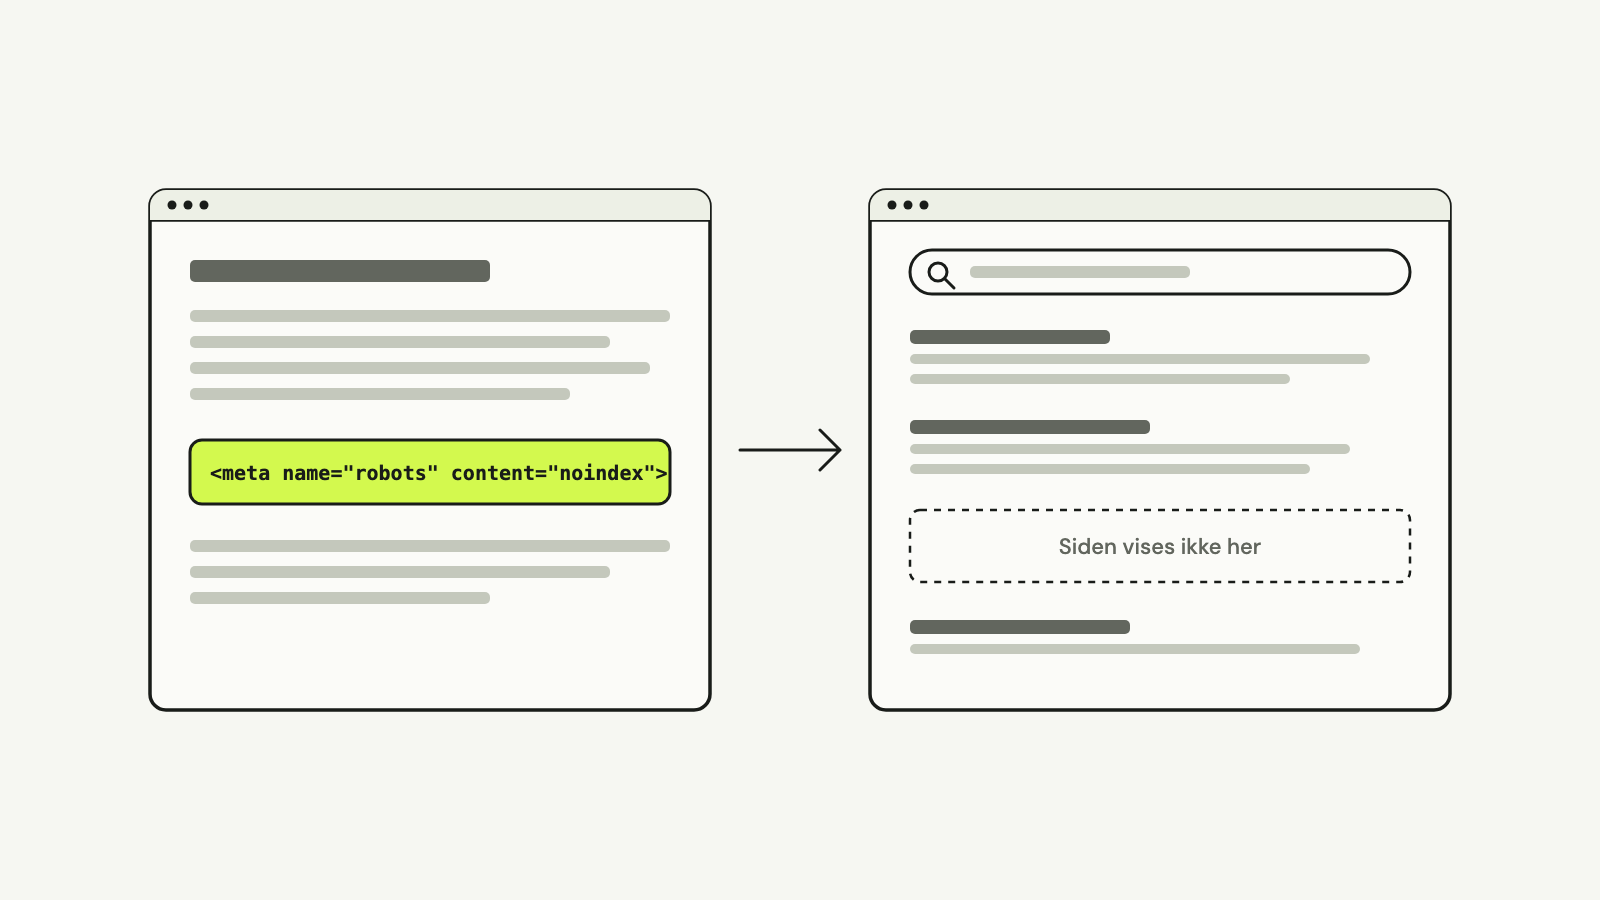
En kvitteringsside, der ikke skal vises, skal have noindex. Spærrer I den her, kan Google ikke se noindex.
Filen er ikke en lås
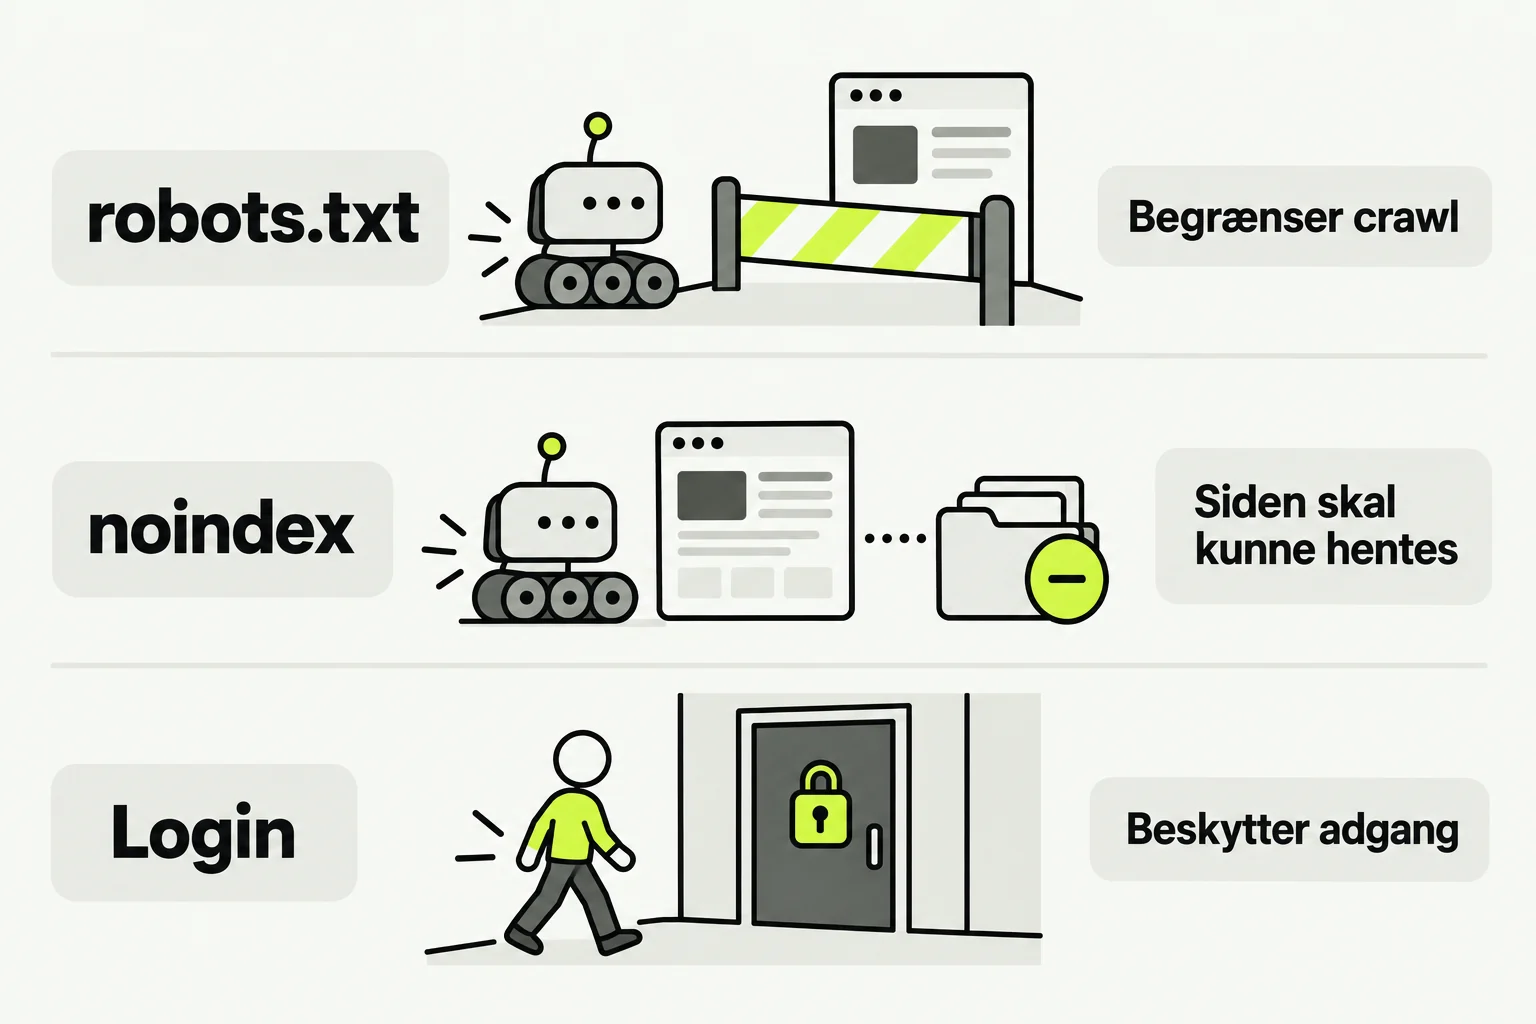
Google Search Central skriver, at filen ikke holder en HTML-side ude af søgningen. Andre sider kan linke til adressen, og så kan den blive vist, ofte uden tekst. Skal siden holdes ude af indekset, bruger I noindex, og siden skal kunne hentes, for at Google kan se det.
En billed- eller videofil er en anden sag. En spærring kan holde selve filen ude af billed- og videoresultaterne. Andre crawlers kan ignorere robots.txt. En side med private oplysninger skal ligge bag et login. Crawl-delay læser Google ikke, og det samme gælder en noindex-linje i robots.txt. Noindex virker kun på selve siden eller i serverens svar.
Når filen mangler
Findes filen ikke, og svarer adressen 404, henter Google, som om der ingen spærring er. Det er ikke usædvanligt: HTTP Archives Web Almanac 2025 fandt, at robots.txt svarede 404 på omkring 13 % af de undersøgte sites. Tjek /robots.txt, når siden er lagt online. Der må ikke stå Disallow: /.
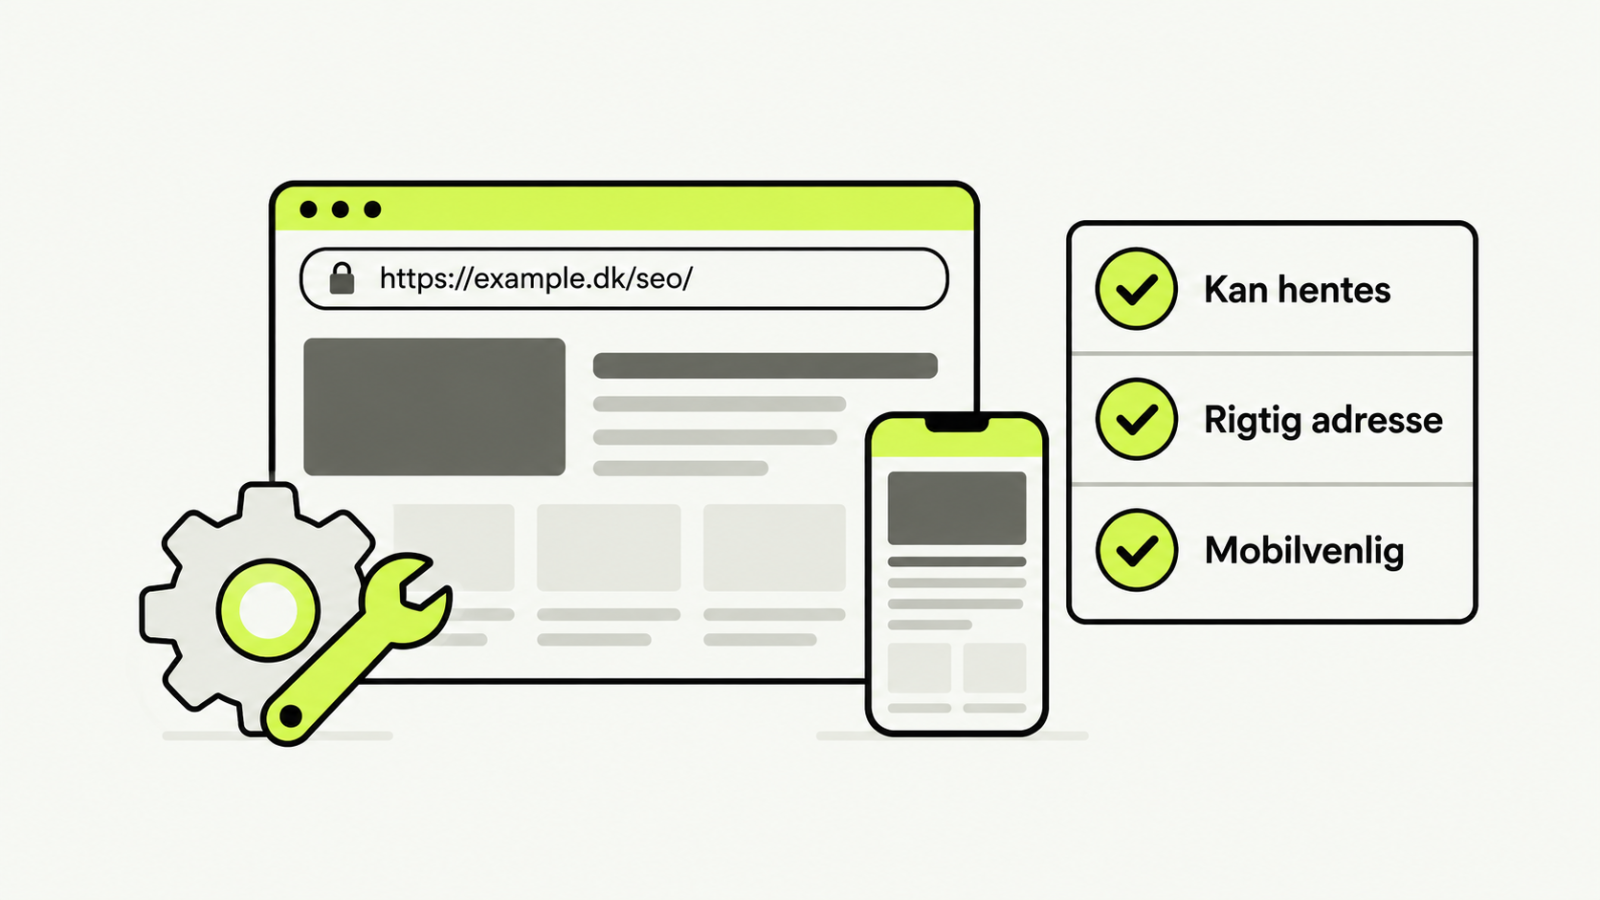
Kontrollér reglerne på de konkrete adresser
Googles robots.txt-specifikation beskriver, at filen gælder for samme protokol, værtsnavn og port. Stier skelner mellem store og små bogstaver. Ved overlappende regler vælger Google den mest specifikke, og ved lige specifikke regler den mindst restriktive. Google læser højst de første 500 KiB af filen og gemmer den typisk i op til 24 timer.
- Åbn den offentlige
/robots.txtpå det præcise domæne, kunderne bruger. - Vælg en ydelsesside, en nødvendig ressourcefil og en adresse, der skal begrænses. Kontrollér hver mod den relevante user-agent-gruppe.
- Tjek resultatet for en vigtig side med URL-inspektion i Search Console efter ændringen. Google kan have en tidligere robots.txt i cache. Robots.txt-rapporten i Search Console viser, hvornår Google sidst hentede filen, om hentningen lykkedes, og eventuelle fejl i filen. Efter en vigtig rettelse kan I bede om, at filen hentes igen.
En manglende fil med 404 er ikke det samme som en serverfejl. Svarer /robots.txt med en 5xx-fejl, stopper Google ifølge specifikationen med at crawle sitet i de første 12 timer og bruger derefter den sidst gemte udgave af filen i op til 30 dage. Undersøg derfor statuskoden frem for blot at se efter tekst.
Hvis målet er at holde en offentlig HTML-side ude af søgning, skal den kunne crawles, så Google kan se noindex-direktivet. Se Google Search Centrals vejledning om noindex.
Hos os er robots.txt en del af SEO-forløbet, når filen spærrer sider, der skal findes, eller lader admin stå åben. En gennemgang af robots.txt er en fast del af vores arbejde med teknisk SEO.
Kilder
- IETF, RFC 9309: Robots Exclusion Protocol, rfc-editor.org.
- Google Search Central, Introduction to robots.txt, developers.google.com.
- Google Crawling Infrastructure, How Google interprets the robots.txt specification, developers.google.com.
- Google Search Central, Block Search indexing with noindex, developers.google.com.
- Search Console Help, robots.txt report, support.google.com.
- HTTP Archive, Web Almanac 2025: SEO, almanac.httparchive.org.