Indhold
- Det vigtigste
- Sådan gjorde vi
- 1. Hvem blokerer AI-crawlerne?
- 2. Medierne lukker, webshops holder åbent
- 3. De største sites blokerer oftest
- 4. Gør hjemmesiderne det let for AI at forstå dem?
- 5. De oversete basisting
- 6. Platformen gør en forskel
- 7. Cookies og tracking
- Kommer man med i AI-svarene, hvis siden er klar?
- Hvad betyder det for jeres virksomhed?
- Brug tallene
- Bilag: de 39 sites, der blokerer ChatGPT's søgning
- Om undersøgelsen
Når kunder spørger ChatGPT, Perplexity eller Googles AI-oversigter, henter de svarene fra hjemmesider, de må læse. Om en hjemmeside må læses, styres af en lille fil, robots.txt, som kan sige ja eller nej til hver enkelt AI-crawler. Strukturerede data og llms.txt gør det samtidig lettere for AI at forstå, hvem en virksomhed er. Vi ville vide, hvordan danske hjemmesider har sat det op, så vi tjekkede de 1.000 mest besøgte .dk-domæner.
Det vigtigste
- 16 % af de mest besøgte danske hjemmesider blokerer ChatGPT’s træningscrawler (GPTBot). Blandt medierne er det 74 %.
- De fleste blokerer kun træningen. 107 af de 139, der blokerer GPTBot, lader stadig ChatGPT’s søgecrawler (OAI-SearchBot) komme ind, så de kan citeres i ChatGPT-svar.
- Nogle lukker helt af. Blandt andre DR, TV 2, Ekstra Bladet, Information og Zetland blokerer også ChatGPT’s søgecrawler. Deres indhold kan derfor ikke citeres med link i ChatGPT’s søgesvar.
- De største blokerer mest. Blandt de 100 mest besøgte blokerer 32 % GPTBot.
- Webshops holder døren åben. Kun 7 % blokerer GPTBot, og kun 1 % blokerer ChatGPT’s søgning.
- 12 % har en llms.txt-fil til AI-modeller, men mindst hver femte af dem er lavet automatisk af Shopify, Yoast eller Rank Math. Halvdelen mangler strukturerede data.
- 29 % af forsiderne har ingen H1-overskrift i den HTML, en crawler ser. For Magento-shops er det 20 af 27.
Sådan gjorde vi
- Udvalg: De 1.000 mest besøgte .dk-domæner på Tranco-listen (liste-ID 746WX), en anerkendt forskningsliste over populære domæner.
- Målt: 4. november 2026. 853 af de 1.000 domæner svarede med en forside. Resten var omdirigeringer, tekniske domæner eller blokerede automatiske besøg.
- Hentet: forsiden, robots.txt og llms.txt, med én forespørgsel pr. fil.
- AI-crawlere: Vi tjekkede, om robots.txt forbyder hver crawler at hente forsiden (“/”). En hjemmeside uden robots.txt tæller som “ikke blokeret”.
- Segmenter: Medierne er udvalgt i hånden. Webshops samt offentlige og uddannelse er bestemt ud fra domæne, platform og schema-typer. Alt andet er “øvrige”.
- Begrænsninger: Vi har kun målt forsiden og robots.txt. Nogle hjemmesider blokerer AI på andre måder, for eksempel via deres CDN. Cookiebannere og tracking, der indlæses via Google Tag Manager, kan ikke ses i forsidens HTML, så de tal er minimumstal.
Hele datasættet kan hentes her: datasæt som CSV. Det må gerne bruges med kildeangivelse og link til denne side.
1. Hvem blokerer AI-crawlerne?
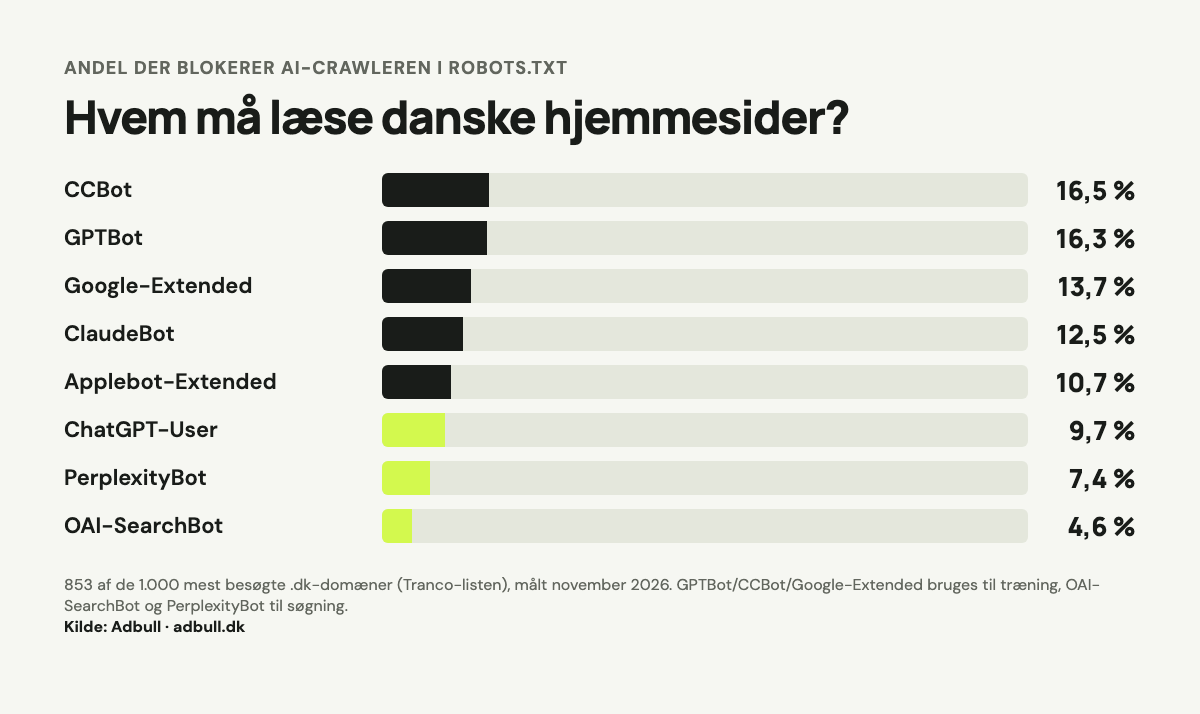
| Crawler | Bruges til | Blokeret af |
|---|---|---|
| CCBot (Common Crawl) | Træningsdata til mange AI-modeller | 16,5 % |
| GPTBot (OpenAI) | Træning af ChatGPT | 16,3 % |
| Google-Extended | Træning af Gemini (påvirker ikke Google-søgning) | 13,7 % |
| ClaudeBot (Anthropic) | Træning af Claude | 12,5 % |
| meta-externalagent | Træning af Metas AI | 12,1 % |
| Applebot-Extended | Træning af Apple Intelligence | 10,7 % |
| Bytespider (ByteDance) | Træning | 10,4 % |
| ChatGPT-User | Når en bruger beder ChatGPT åbne en side | 9,7 % |
| PerplexityBot | Perplexitys søgning | 7,4 % |
| OAI-SearchBot | ChatGPT’s søgning og citater | 4,6 % |
| Claude-SearchBot | Claudes søgning | 4,3 % |
Mønstret er tydeligt. Danske hjemmesider skelner mellem træning og søgning. Mange siger nej til, at deres indhold bruges til at træne modeller, men ja til at blive fundet og citeret, når nogen spørger. 107 af de 139 sites, der blokerer GPTBot, tillader stadig OAI-SearchBot. Forskellen på crawlerne og hvad hver af dem bruges til, står i guiden til AI-crawlere og robots.txt.
2. Medierne lukker, webshops holder åbent
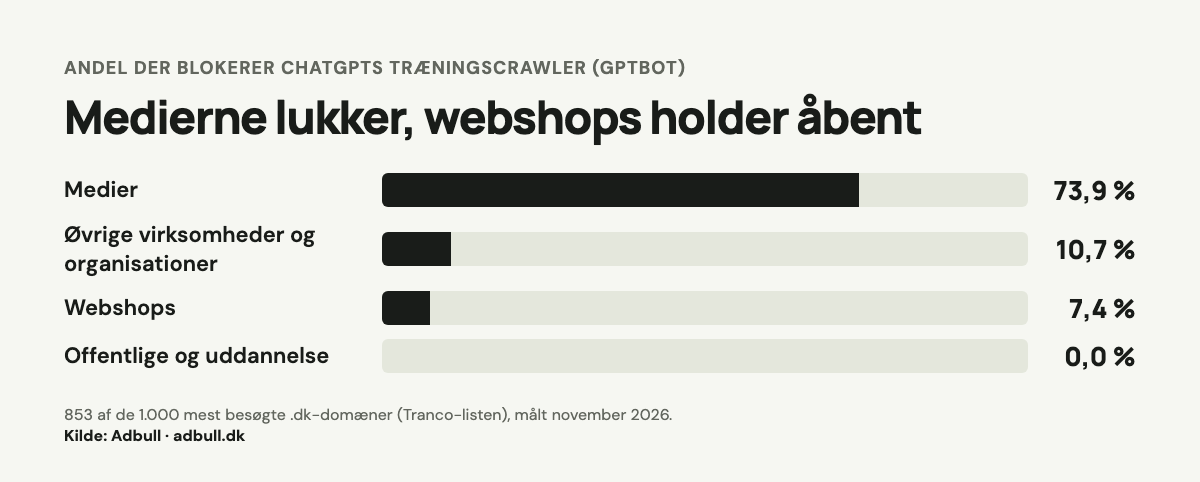
| Segment | Antal | GPTBot | OAI-SearchBot | ClaudeBot | PerplexityBot | Google-Extended |
|---|---|---|---|---|---|---|
| Medier | 88 | 73,9 % | 18,2 % | 43,2 % | 38,6 % | 62,5 % |
| Øvrige | 625 | 10,7 % | 3,5 % | 10,1 % | 4,5 % | 8,8 % |
| Webshops | 95 | 7,4 % | 1,1 % | 6,3 % | 1,1 % | 7,4 % |
| Offentlige og uddannelse | 45 | 0,0 % | 0,0 % | 0,0 % | 0,0 % | 0,0 % |
Medierne har en forretning at beskytte, og tre ud af fire blokerer træningen. De fleste lader stadig ChatGPT’s søgning komme ind, for eksempel bt.dk, politiken.dk, berlingske.dk, jyllands-posten.dk og borsen.dk. En mindre gruppe lukker helt af, også for søgningen: dr.dk, tv2.dk, ekstrabladet.dk, information.dk og zetland.dk. ritzau.dk blokerer alle robotter, også Google. Det er altså ikke en særlig AI-regel.
Rettet 16. november 2026: Medierne er nu udvalgt i hånden. Den første udgave sorterede automatisk og talte 77 medier. 17 af dem var ikke medier, og flere rigtige medier manglede. Det rigtige tal er 88 medier, og 74 % af dem blokerer GPTBot, ikke 65 %. Tallene for de andre grupper er rettet på samme måde.
Webshops og det offentlige gør det modsatte. De vil gerne findes, også i AI-svar.
Alle 39 sites, der blokerer ChatGPT’s søgecrawler, står i listen nederst.
3. De største sites blokerer oftest
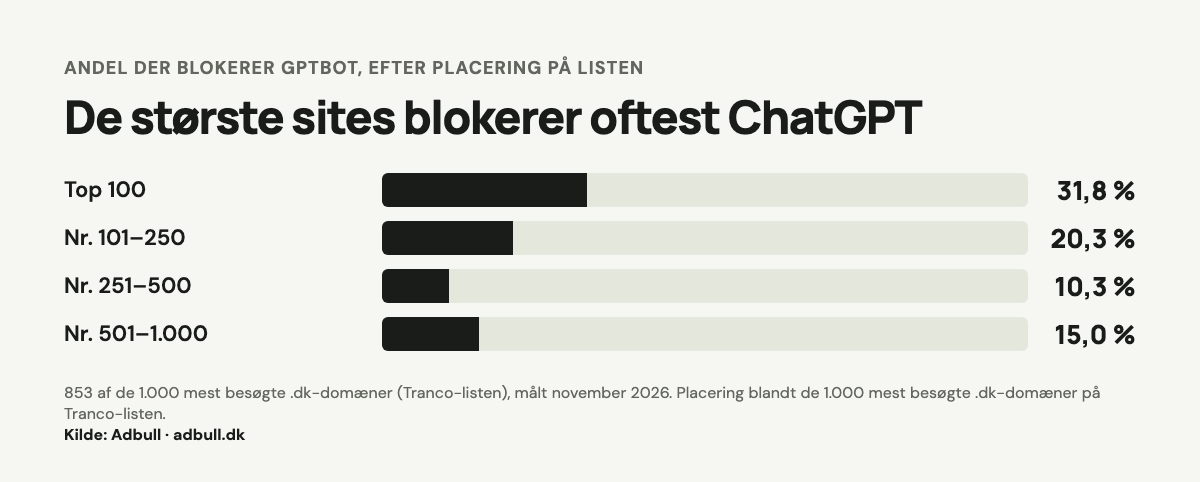
Blandt de 100 mest besøgte danske sites blokerer næsten hver tredje ChatGPT’s træningscrawler. Længere nede på listen er det hvert sjette til tiende site. Det er især de store medier, der trækker tallet op, men også jobportaler, opslagsværker og markedspladser som Jobindex, Ordnet og Vinted lukker for træningen.
4. Gør hjemmesiderne det let for AI at forstå dem?
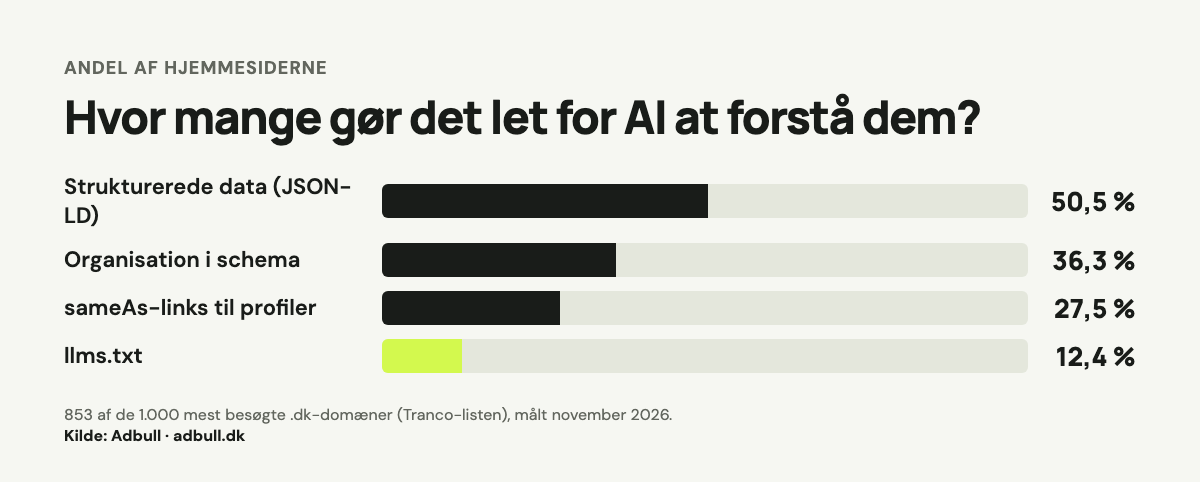
- 50,5 % har strukturerede data (JSON-LD) på forsiden. 44,7 % har slet ingen.
- 36,3 % fortæller med schema, hvilken organisation de er.
- 27,5 % linker til deres officielle profiler med sameAs. Det hjælper AI med at koble virksomheden til LinkedIn, Wikipedia og andre profiler.
- 12,4 % (106 sites) har en llms.txt. Det er en ny, frivillig fil, der fortæller AI-modeller, hvad siden handler om. Blandt dem er Boligsiden, Elgiganten, Harald Nyborg, Biltema, Nordnet og Norlys. Mindst 22 af filerne er lavet automatisk: 16 af Shopify, der nu lægger en fil med instruktioner til AI-agenter på butikkerne, og 6 af SEO-plugins som Yoast og Rank Math.
5. De oversete basisting
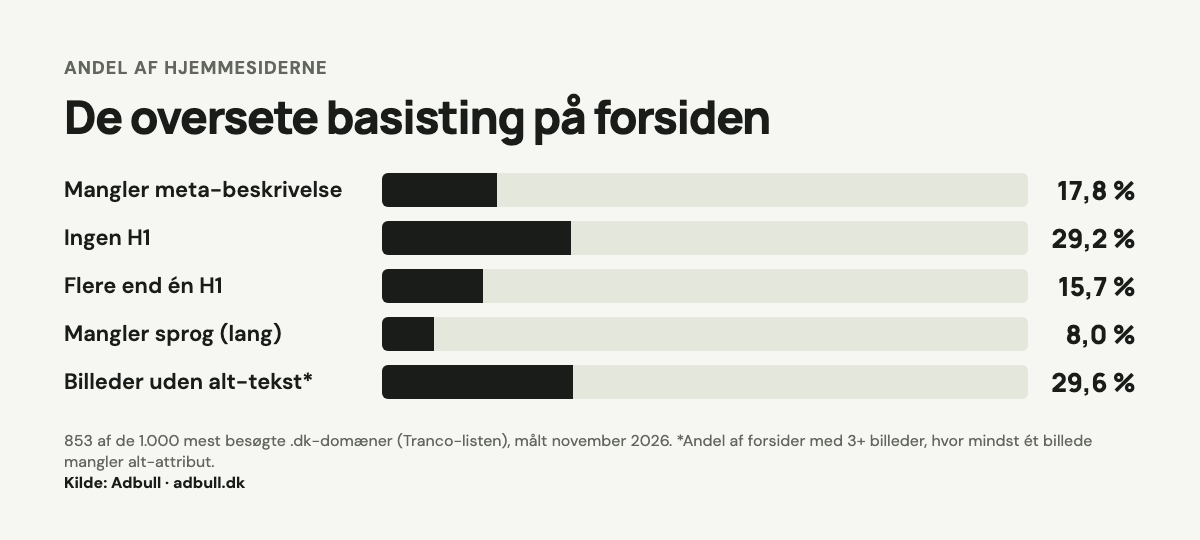
- 29,2 % har ingen H1 i den HTML, der sendes til crawlere. Mange AI-crawlere kører ikke JavaScript, så indhold, der først bygges i browseren, kan være usynligt for dem. Magento-shops skiller sig ud: 20 af 27 har ingen H1 i den rå HTML.
- 17,8 % mangler en meta-beskrivelse på forsiden.
- 47,1 % mangler et og:image, så de ser kedelige ud, når de deles.
- 8,0 % angiver ikke sproget (lang), som skærmlæsere og browsere bruger.
- 29,6 % af forsiderne med mindst tre billeder har billeder helt uden alt-attribut.
6. Platformen gør en forskel
Hvilket system hjemmesiden er bygget på, ses tydeligt i tallene. Tabellen viser de platforme, vi kunne genkende på mindst 18 sites. Resten bruger egne løsninger eller platforme, vi ikke kunne se i HTML’en.
| Platform | Antal | JSON-LD | Ingen H1 | llms.txt | Blokerer GPTBot |
|---|---|---|---|---|---|
| WordPress | 89 | 74 % | 24 % | 13 % | 12 % |
| Umbraco | 68 | 38 % | 29 % | 9 % | 4 % |
| Next.js | 60 | 48 % | 27 % | 10 % | 30 % |
| Drupal | 32 | 19 % | 22 % | 3 % | 6 % |
| Sitecore | 31 | 45 % | 35 % | 10 % | 0 % |
| WooCommerce | 29 | 97 % | 21 % | 17 % | 14 % |
| Magento | 27 | 59 % | 74 % | 15 % | 19 % |
| Shopify | 18 | 78 % | 17 % | 100 % | 0 % |
- Magento skiller sig ud: 74 % af forsiderne har ingen H1 i den HTML, serveren sender. Overskriften bygges først med JavaScript.
- WooCommerce og Shopify har næsten altid strukturerede data, fordi platformen eller et plugin lægger dem ind.
- Shopify-butikkerne har alle en llms.txt, og ingen af dem blokerer GPTBot. Det er platformens standard, ikke et valg den enkelte butik har truffet.
- Next.js-sites blokerer oftest AI-træning (30 %), fordi mange medier er bygget på det.
Det betyder, at mange “valg” om AI i praksis er truffet af platformen. Tjek, hvad jeres system gør som standard.
7. Cookies og tracking
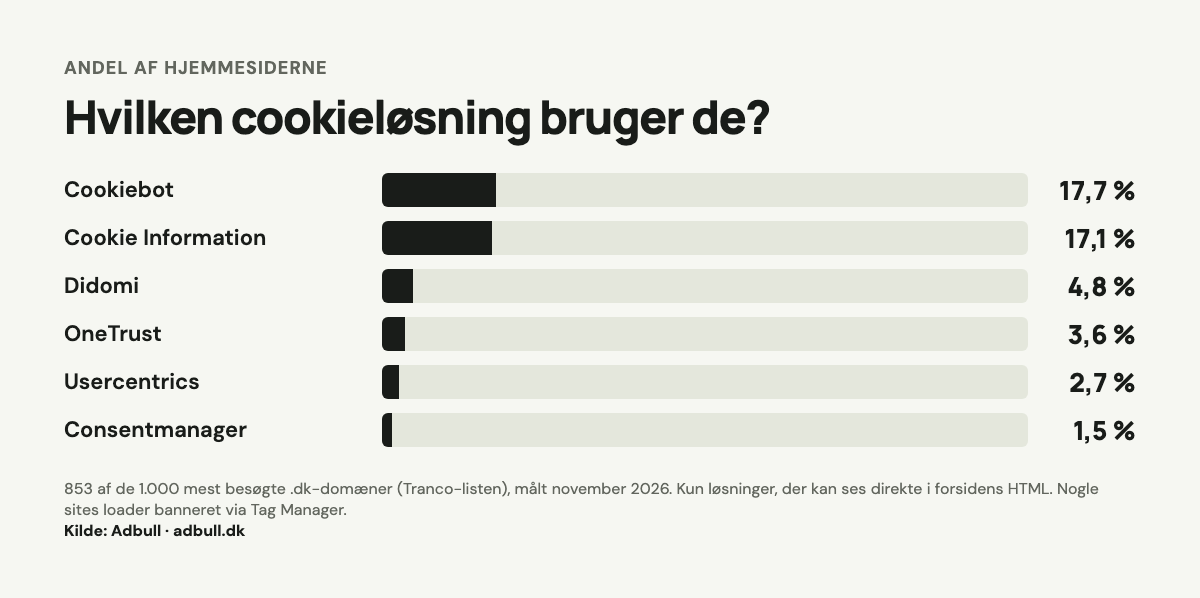
Cookiebot (17,7 %) og Cookie Information (17,1 %) dominerer i Danmark og er næsten lige store. Derefter følger Didomi (4,8 %), OneTrust (3,6 %) og Usercentrics (2,7 %).
Google Tag Manager kan ses direkte på 46,9 % af forsiderne og Meta Pixel på 7,2 %. Begge tal er minimumstal, fordi meget tracking indlæses via Tag Manager.
Kommer man med i AI-svarene, hvis siden er klar?
Teknikken er kun adgangsbilletten. I vores undersøgelse af hvem ChatGPT anbefaler i Aarhus blokerede ingen af de anbefalede virksomheders hjemmesider ChatGPT’s søgning. Men valget blev truffet på anmeldelser, navngivne eksperter og omtale andre steder. Hjemmesiden skal kunne læses, og resten afgøres af bevis.
Hvad betyder det for jeres virksomhed?
- Bestem jer bevidst for AI-crawlerne. Vil I citeres i ChatGPT og Perplexity, så sørg for, at OAI-SearchBot, PerplexityBot og Claude-SearchBot må læse siden. Træningscrawlerne kan I godt sige nej til uden at forsvinde fra AI-søgning.
- Tjek jeres robots.txt. Mange blokerer AI ved et uheld via en skabelon eller et plugin. Den ligger på jeresdomæne.dk/robots.txt.
- Fortæl, hvem I er. Organization-schema med sameAs-links til LinkedIn, Google-profil og andre officielle profiler gør det lettere for AI at genkende jer.
- Overvej en llms.txt. Det er ikke en standard endnu, men 12 % af de store danske sites har allerede en, og den er hurtig at lave.
- Sørg for, at indholdet findes i HTML’en. Overskrifter og tekst skal ikke kun bygges med JavaScript. Det er noget, vi ser på, når vi bygger en ny hjemmeside.
Vil I vide, hvordan jeres egen side står, er det det første, vi kigger på som GEO-bureau. GEO er arbejdet med at blive nævnt i den slags svar.
Brug tallene
Tallene og grafer må gerne bruges med kildeangivelse og link til denne side. Foreslået kildeangivelse:
Adbull (2026): Er danske hjemmesider klar til AI? Undersøgelse af de 1.000 mest besøgte .dk-domæner, målt 4. november 2026. adbull.dk/viden/geo/ai-klar-undersoegelse/
Hele datasættet med alle 853 sites ligger her: datasæt som CSV.
Bilag: de 39 sites, der blokerer ChatGPT’s søgning
Sites blandt de 1.000 mest besøgte .dk-domæner, hvis robots.txt forbyder OAI-SearchBot at hente forsiden. “Plads” er placeringen blandt de 1.000. Nogle er tekniske domæner, fx google.dk og blogspot.dk, der sender videre til et andet site.
| Plads | Domæne | Blokerer også alle andre crawlere |
|---|---|---|
| 2 | ekstrabladet.dk | Nej, kun AI |
| 4 | google.dk | Ja |
| 5 | dr.dk | Nej, kun AI |
| 6 | tv2.dk | Nej, kun AI |
| 15 | bold.dk | Nej, kun AI |
| 22 | bloggersdelight.dk | Ja |
| 59 | information.dk | Nej, kun AI |
| 71 | jobindex.dk | Ja |
| 79 | blogspot.dk | Ja |
| 118 | survey-xact.dk | Ja |
| 152 | krydsordexperten.dk | Ja |
| 166 | ritzau.dk | Ja |
| 168 | ing.dk | Nej, kun AI |
| 174 | pinterest.dk | Ja |
| 233 | csdb.dk | Nej, kun AI |
| 300 | gammeldanskordbog.dk | Ja |
| 360 | risberg.dk | Ja |
| 425 | hay.dk | Ja |
| 449 | powerlygter.dk | Ja |
| 455 | nordschleswiger.dk | Nej, kun AI |
| 492 | smartbake.dk | Ja |
| 513 | jfmid.dk | Ja |
| 528 | version2.dk | Nej, kun AI |
| 558 | illvid.dk | Nej, kun AI |
| 561 | woman.dk | Nej, kun AI |
| 575 | motorcompagniet.dk | Ja |
| 587 | feltet.dk | Nej, kun AI |
| 629 | medicin.dk | Nej, kun AI |
| 669 | discosupport.dk | Nej, kun AI |
| 686 | hillerodelite.dk | Ja |
| 691 | cvrapi.dk | Ja |
| 738 | nyheder.dk | Nej, kun AI |
| 779 | nsd.dk | Nej, kun AI |
| 803 | bilmagasinet.dk | Nej, kun AI |
| 895 | jourbox.dk | Ja |
| 918 | gardindekoratoren.dk | Ja |
| 923 | watchmedier.dk | Nej, kun AI |
| 959 | hchald.dk | Ja |
| 964 | zetland.dk | Ja |
Om undersøgelsen
Undersøgelsen er lavet af Adbull, et digitalt bureau i Aarhus, der arbejder med hjemmesider, SEO, GEO og annoncering. Crawleren er bygget og kørt af Jonathan Martin Lara, partner og ansvarlig for webudvikling, tracking og SEO hos Adbull. Data er indsamlet 4. november 2026. Spørgsmål til tallene: kontakt@adbull.dk eller 42 79 66 34.