Indhold
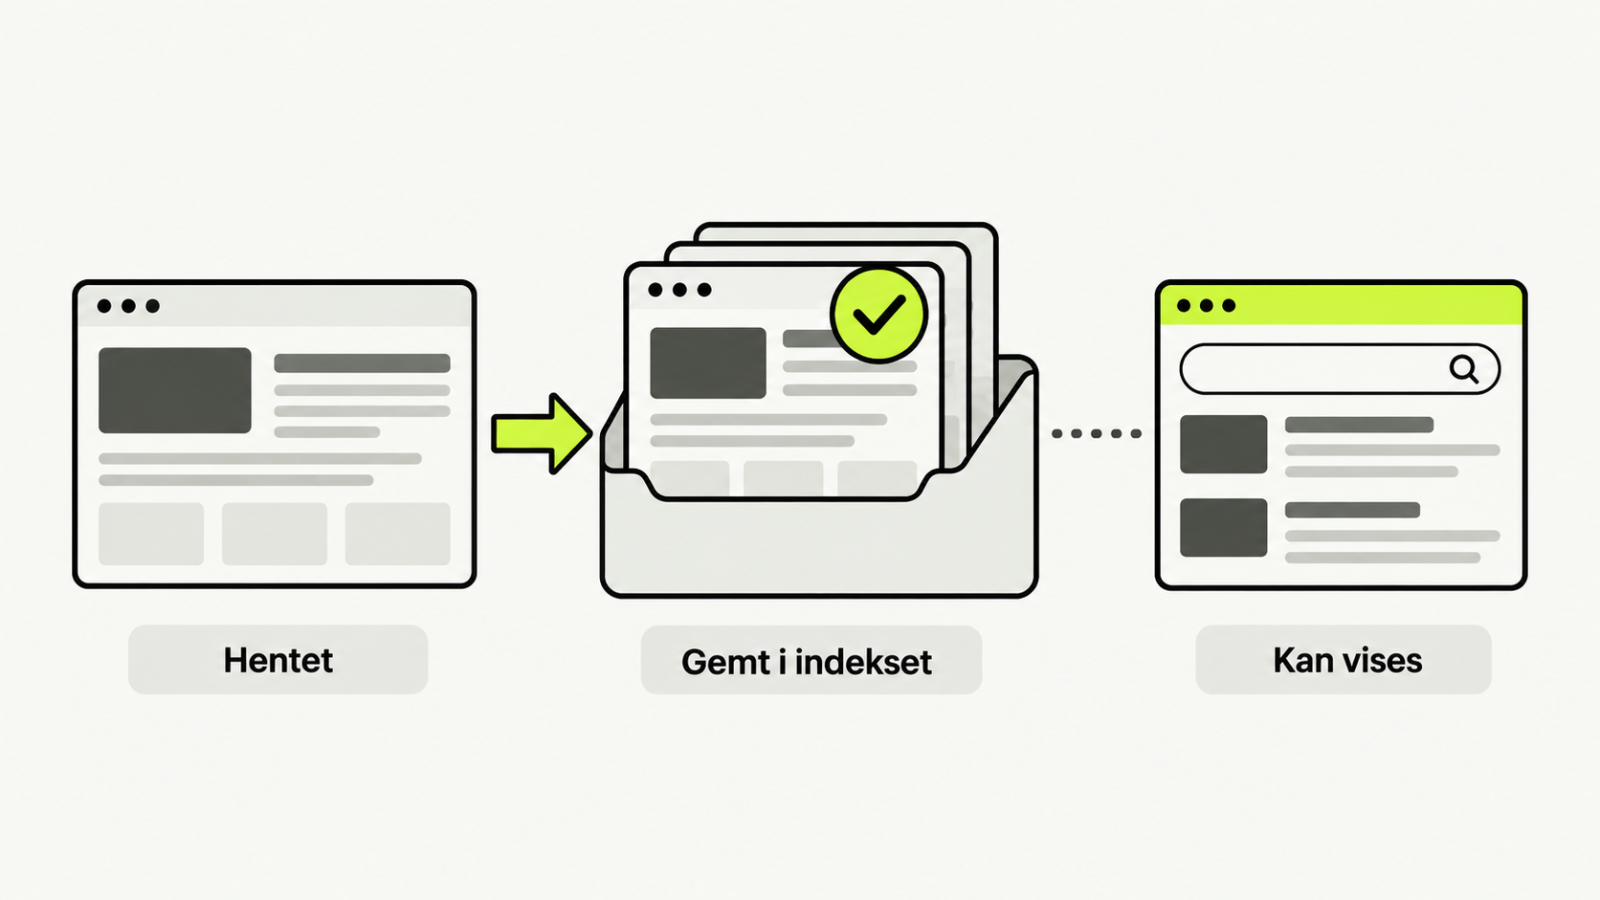
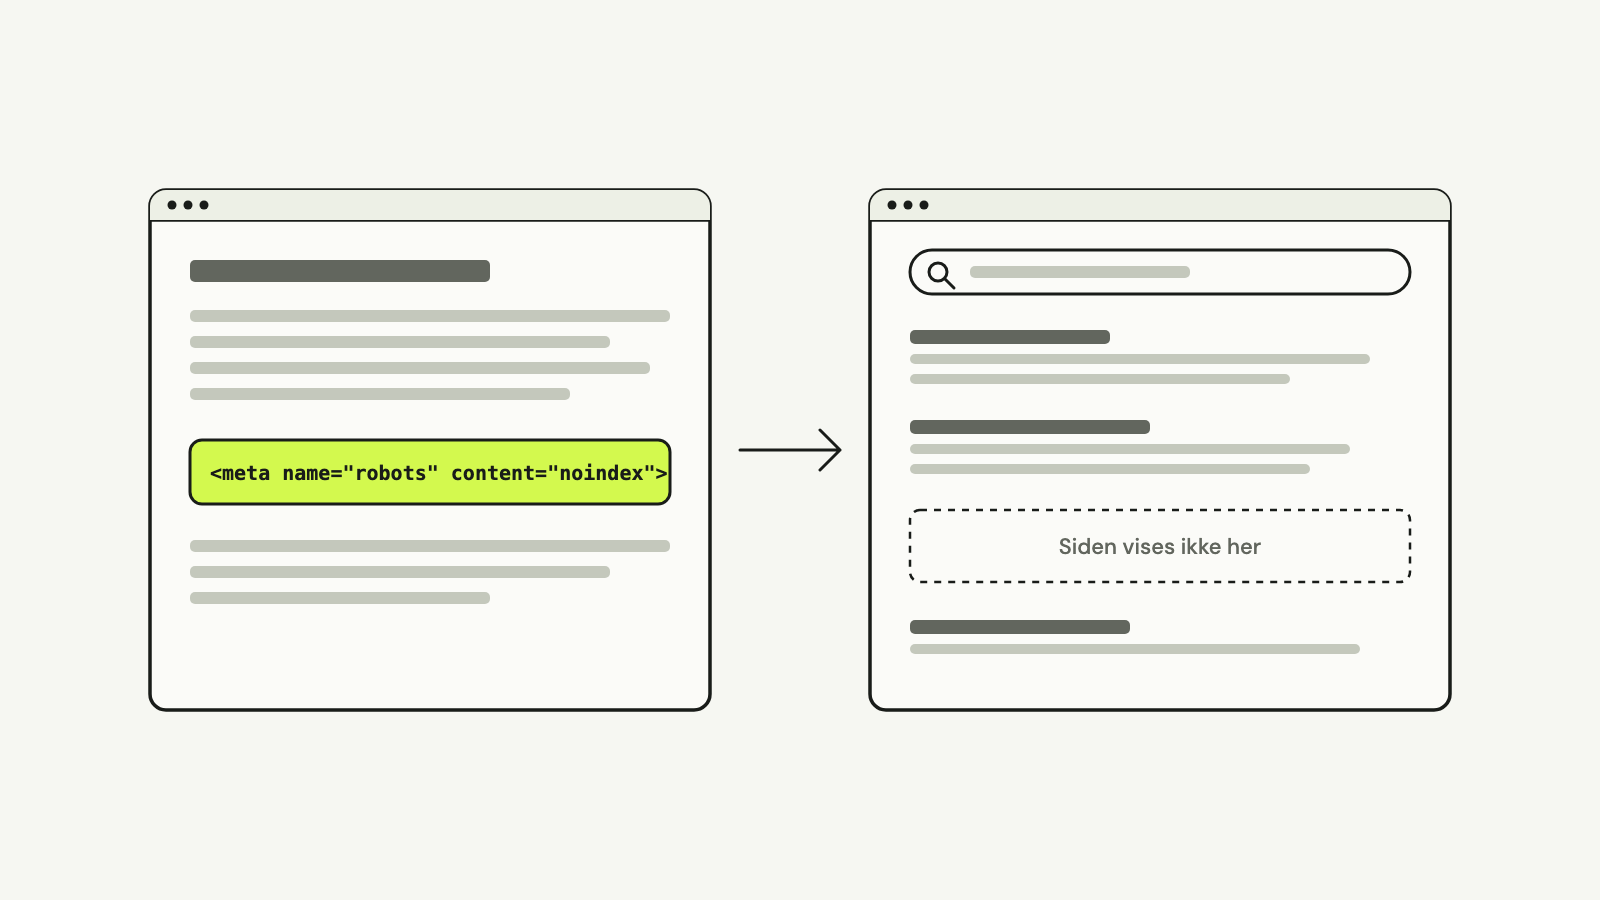
Noindex er en besked til Google om, at en side ikke skal med i søgeresultaterne. Siden findes stadig, kan åbnes og kan linkes til. Den bliver bare ikke vist, når nogen søger. Beskeden står i sidens HTML eller i serverens svar, og Google følger den, så snart siden er hentet igen.
Det er det rigtige værktøj til sider, der skal findes af dem, der har adressen, men ikke af alle andre. Og det er det værktøj, der oftest bruges forkert, fordi det bliver blandet sammen med robots.txt og canonical. Her er, hvad det gør, hvornår det er det rigtige valg, og hvad I skal bruge i stedet, når det ikke er.
Hvad noindex gør, og hvad det ikke gør
Noindex er en robots-instruktion. Den står enten som et meta-tag i sidens <head>:
<meta name="robots" content="noindex">eller som en HTTP-header, X-Robots-Tag: noindex, i serverens svar. Headeren bruges til filer, der ikke har nogen HTML at skrive i, fx PDF’er og billeder. Begge dele betyder det samme, og Google Search Central beskriver dem som ligeværdige. En noindex-linje i robots.txt virker derimod ikke. Den understøtter Google ikke.
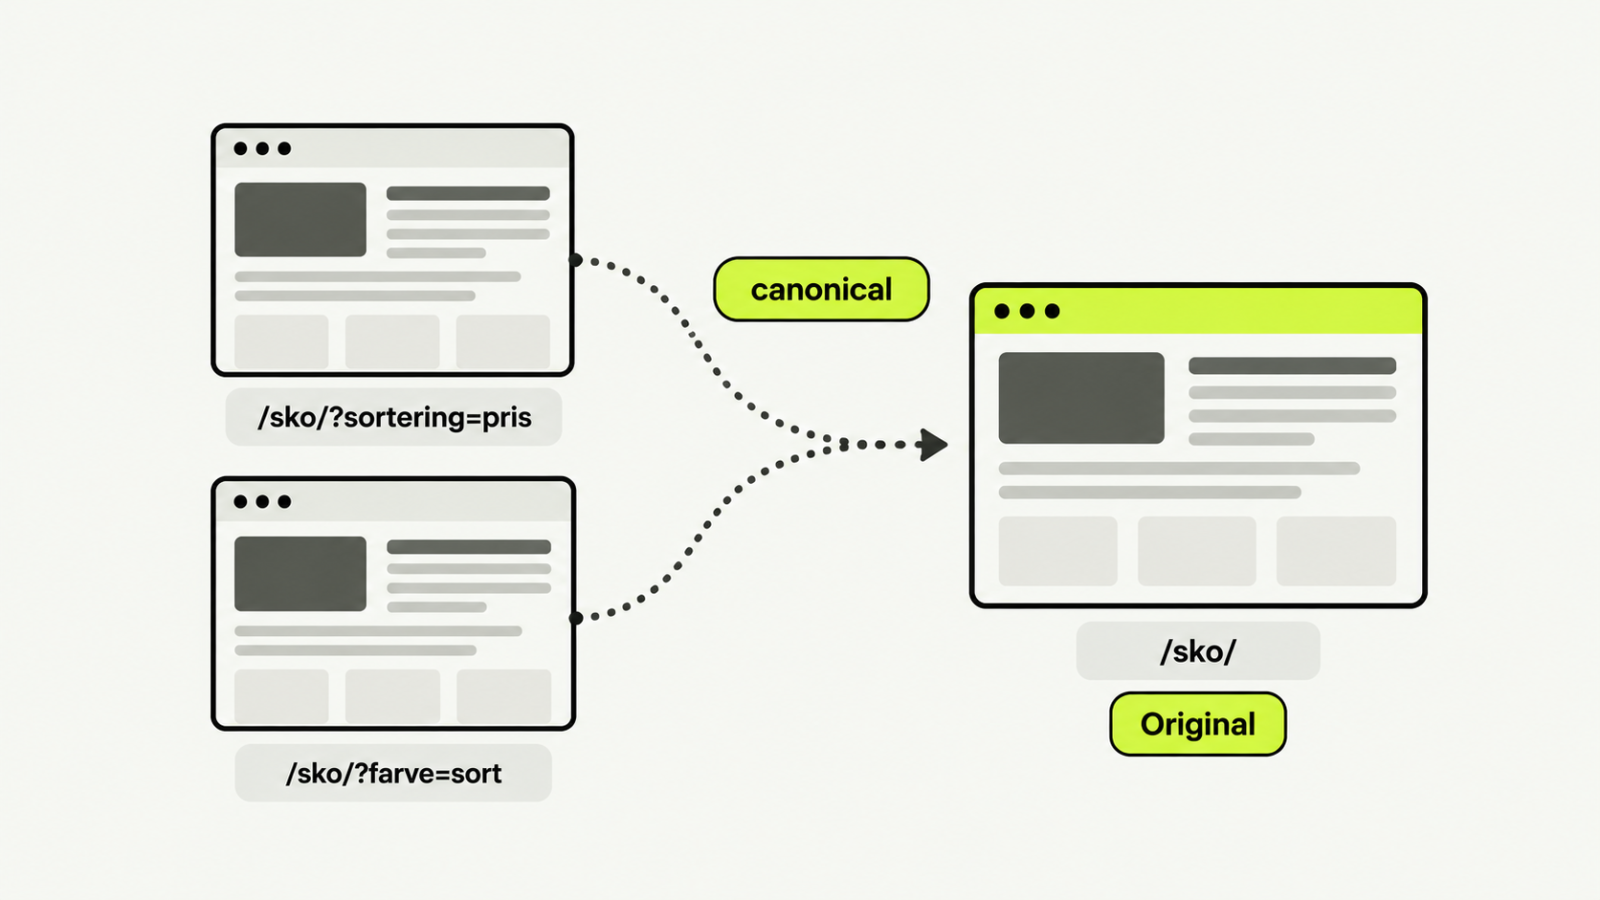
Noindex fjerner siden fra indekset. Den forhindrer ikke, at siden hentes. Tværtimod: Google skal hente siden for at se instruktionen. Og den siger ikke noget om, hvilken side der er den rigtige. Har I to sider med samme indhold, og vil I have den ene vist, er det canonical, I skal bruge, ikke noindex.
Noindex kan stå alene eller sammen med nofollow: noindex, nofollow siger også, at links på siden ikke skal følges. Det er sjældent det, I vil. En side kan godt være uden for indekset og stadig sende læseren og Google videre til de sider, den linker til. Hvad nofollow gør på et enkelt link, står under nofollow.
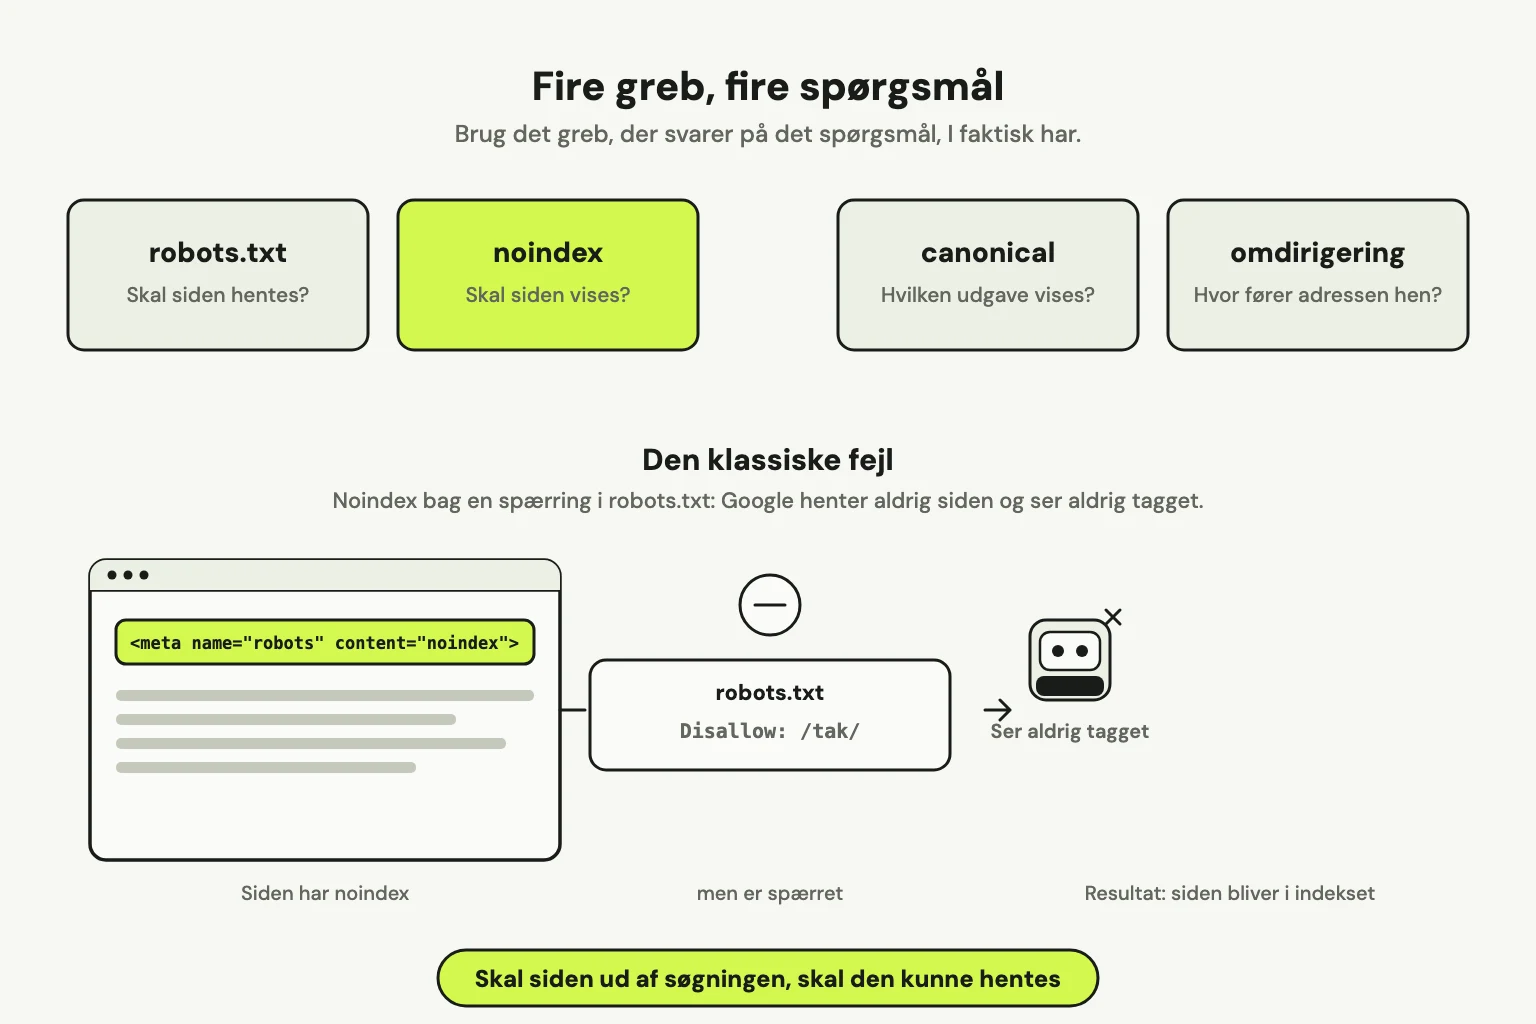
Den klassiske fejl: noindex bag en spærring
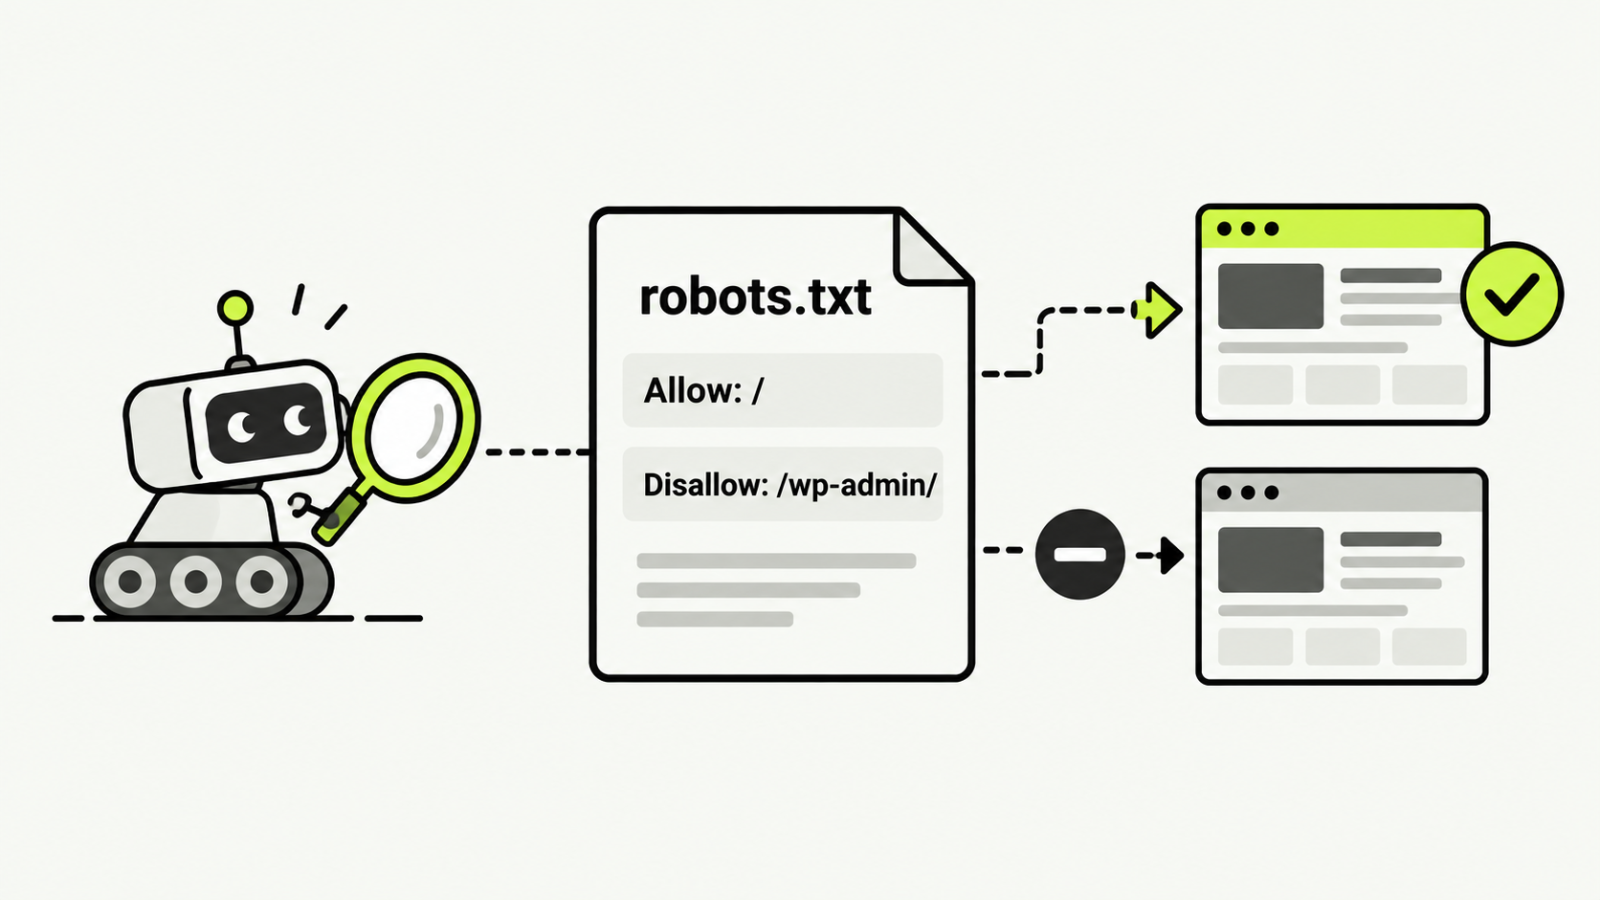
Den fejl, vi ser oftest, er en side med noindex, som samtidig er spærret i robots.txt. Tanken er, at to låse er bedre end én. Resultatet er det modsatte: Fordi siden er spærret, henter Google den ikke, og så ser Google aldrig noindex. Siden kan blive stående i indekset med sin adresse og en linje om, at der ikke er nogen beskrivelse. Det er præcis den situation, Search Console kalder “Indekseret, men blokeret af robots.txt”. Search Consoles hjælp forklarer, at Google kan indeksere en blokeret side ud fra de links, der peger på den.
Reglen er enkel: Skal siden ud af søgeresultaterne, skal den kunne hentes. Brug noindex, og lad den være åben i robots.txt. Robots.txt er til sider, Google ikke skal bruge tid på at hente, fx interne søgeresultater med tusind varianter. Forskellen er forklaret under robots.txt.
Hvornår noindex er det rigtige valg
Noindex passer til sider, der har en funktion for den, der er på sitet, men ikke er et svar på en søgning:
- Tak-sider efter en formular eller et køb. De skal kunne åbnes, men ingen skal lande på dem fra Google.
- Interne søgeresultater og filtersider, der kombinerer de samme produkter på nye måder. Her er noindex ofte første skridt, og robots.txt kommer først, hvis mængden bliver et problem.
- Tag- og datoarkiver i WordPress, der samler indlæg uden at tilføje noget, kategorien ikke allerede gør.
- Kampagnesider med kort levetid, som kun skal findes via annoncen eller nyhedsbrevet.
- Login, kurv, kundekonto og andre sider, der kun giver mening midt i en handling.
- Udkast og testsider, der ligger på det rigtige domæne, mens de bliver færdige.
Fælles for dem er, at siden skal blive liggende. Den har et formål. Den skal bare ikke konkurrere med jeres rigtige sider i søgeresultaterne.
Hvornår det er det forkerte valg
- Siden skal væk. Så fjern den. Har den en reel afløser, så omdirigér til den. Har den ikke, så svar 404 eller 410. Noindex på en side, der ikke skal findes af nogen, er bare en side, der ligger og venter.
- Siden er en kopi. Varianter med sporingsparametre, den samme tekst på to adresser, print-udgaver. Det er duplicate content, og svaret er canonical, så den rigtige udgave samler værdien.
- I er i tvivl, om siden er god nok. Noindex er ikke en parkeringsplads. Gør siden bedre, slå den sammen med en anden, eller fjern den.
- Hele sitet skal skjules. Et udviklingssite skal bag et login eller på et domæne, der ikke er offentligt. Noindex på alle sider virker, men glemmes ved lanceringen oftere, end man skulle tro. WordPress’ indstilling “Bed søgemaskiner om ikke at indeksere dette websted” sætter
noindex, nofollowpå alle sider. Sådan har det været siden WordPress 5.3, og indstillingen er den første, I skal kontrollere, når et nyt site ikke bliver fundet.
Noindex over lang tid
Googles John Mueller sagde i 2017, at en side, der står med noindex længe, til sidst behandles som noindex, nofollow. Når Google har fjernet siden helt, følger den heller ikke længere dens links. Hvor lang tid det tager, afhænger ifølge Mueller af blandt andet crawlfrekvensen. Udtalelsen er refereret af Search Engine Roundtable. Det betyder, at en noindex-side ikke kan bruges som fordeler af links til resten af sitet. Har I en oversigtsside, der er sat til noindex, men som er den eneste vej til et sæt undersider, risikerer de undersider at blive forældreløse i Googles øjne. Sørg for, at vigtige sider også er linket fra sider, der er med i indekset.
Sådan ser I, hvad der er sat til noindex
Åbn Search Console og gå til sideindekseringsrapporten. Under “Ikke indekseret” står gruppen for noindex. Googles danske hjælpeside kalder den “Webadressen er angivet som ‘noindex'”, mens den engelske brugerflade viser “Excluded by ‘noindex’ tag”. Her står alle de adresser, Google har hentet og holdt ude. Gennemgå listen én gang. Det er her, I finder den ydelsesside, nogen satte til noindex under en ombygning og glemte igen.
På den enkelte side kan I se tagget i kildekoden eller med værktøjet Undersøg URL i Search Console, som viser både meta-tag og HTTP-header. I WordPress med Yoast står indstillingen under Avanceret på hver side som “Tillad søgemaskiner at vise dette indhold i søgeresultater?”. Står der Nej, er siden noindex. Yoast kan også sætte det samlet for en indholdstype eller et arkiv under Yoast SEO › Indstillinger, i afsnittene Indholdstyper og Kategorier og tags.
Fjerner I et noindex, sker der ikke noget, før Google har hentet siden igen. Bed om indeksering i Search Console, og regn med dage eller uger, ikke minutter. Det gælder begge veje. Google skriver i sin vejledning om noindex, at det for mindre vigtige sider kan tage måneder, før siden bliver hentet igen og ændringen bliver set.
Tjekliste
- Hent listen over noindex-adresser i sideindekseringsrapporten i Search Console, og kontrollér, at ingen af jeres vigtige sider står på den.
- Kontrollér, at ingen noindex-side samtidig er spærret i robots.txt.
- Gennemgå tag-, dato- og forfatterarkiver i WordPress, og sæt noindex på dem, der ikke har et eget formål.
- Sæt noindex på tak-sider, interne søgeresultater og kampagnesider med kort levetid.
- Brug canonical til kopier og omdirigering eller 410 til sider, der skal væk, i stedet for noindex.
- Kontrollér, at sider, der kun er linket fra noindex-sider, også er linket fra en side i indekset.
- Kontrollér WordPress’ indstilling for synlighed i søgemaskiner, hver gang et site går live.
Noindex er ét af de fire greb, der styrer, hvad Google viser: robots.txt styrer, hvad der hentes, noindex styrer, hvad der vises, canonical styrer, hvilken udgave der vises, og omdirigering styrer, hvor en gammel adresse fører hen. Bruger I det rigtige greb til den rigtige opgave, er resten af den tekniske gennemgang meget nemmere. Fejl i noindex er noget af det første, vi kigger efter i arbejdet med teknisk SEO.
Kilder
- Google Search Central, Block Search indexing with noindex, developers.google.com.
- Search Console Help, Page indexing report, support.google.com.
- WordPress Core, Changes to prevent search engines indexing sites, make.wordpress.org.
- Search Engine Roundtable (Barry Schwartz), Google: Long Term Noindex Will Lead To Nofollow On Links, december 2017, seroundtable.com.