Indhold
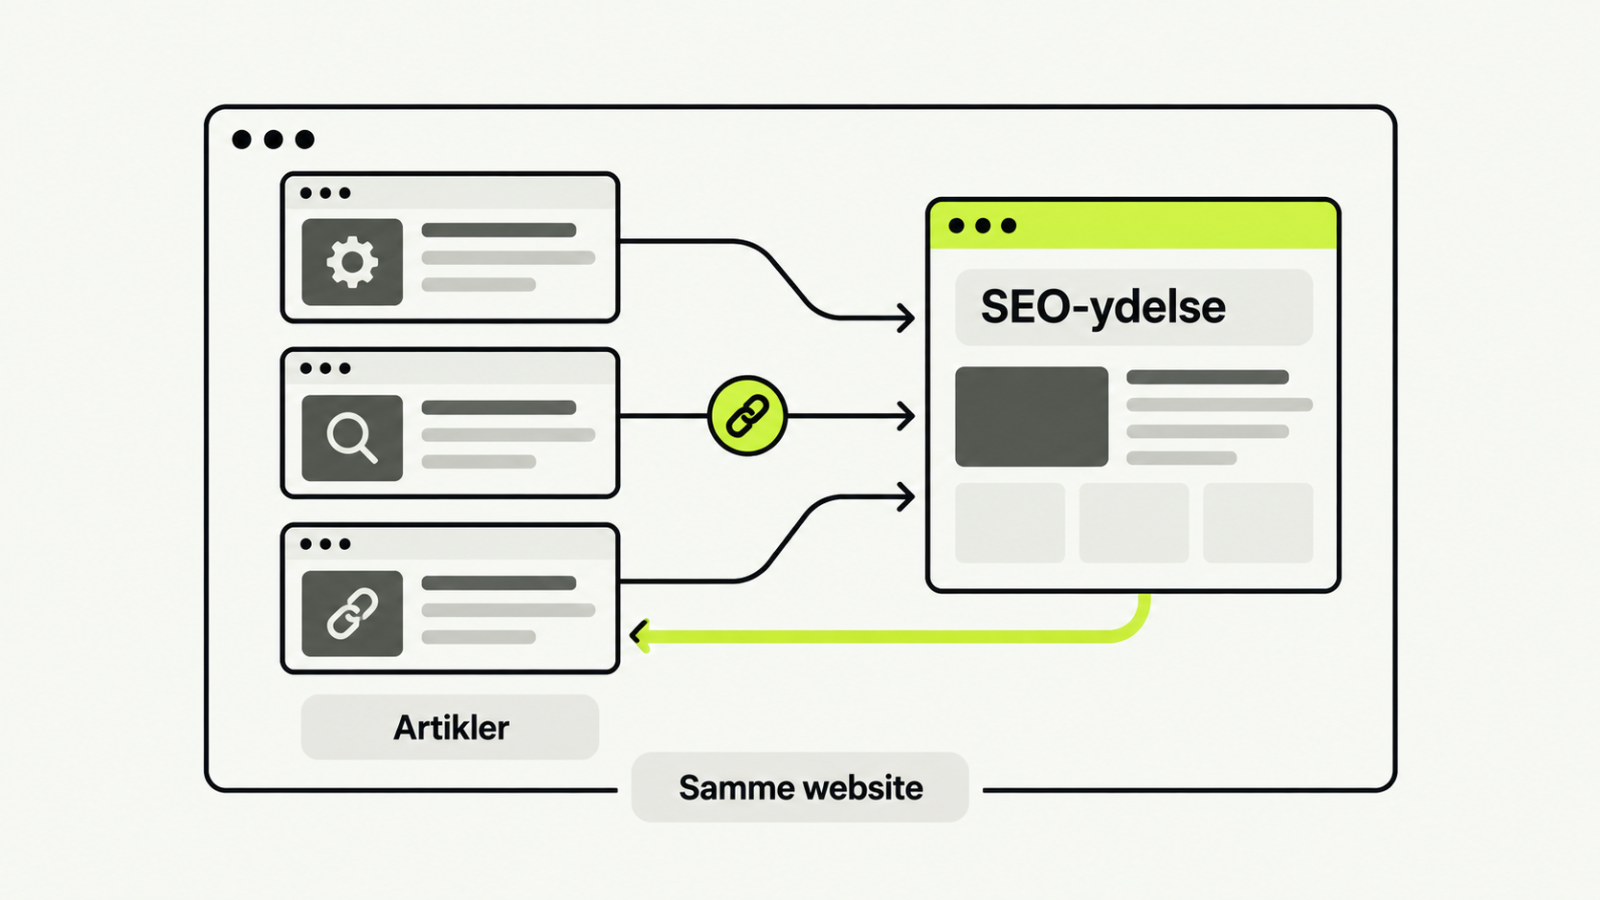
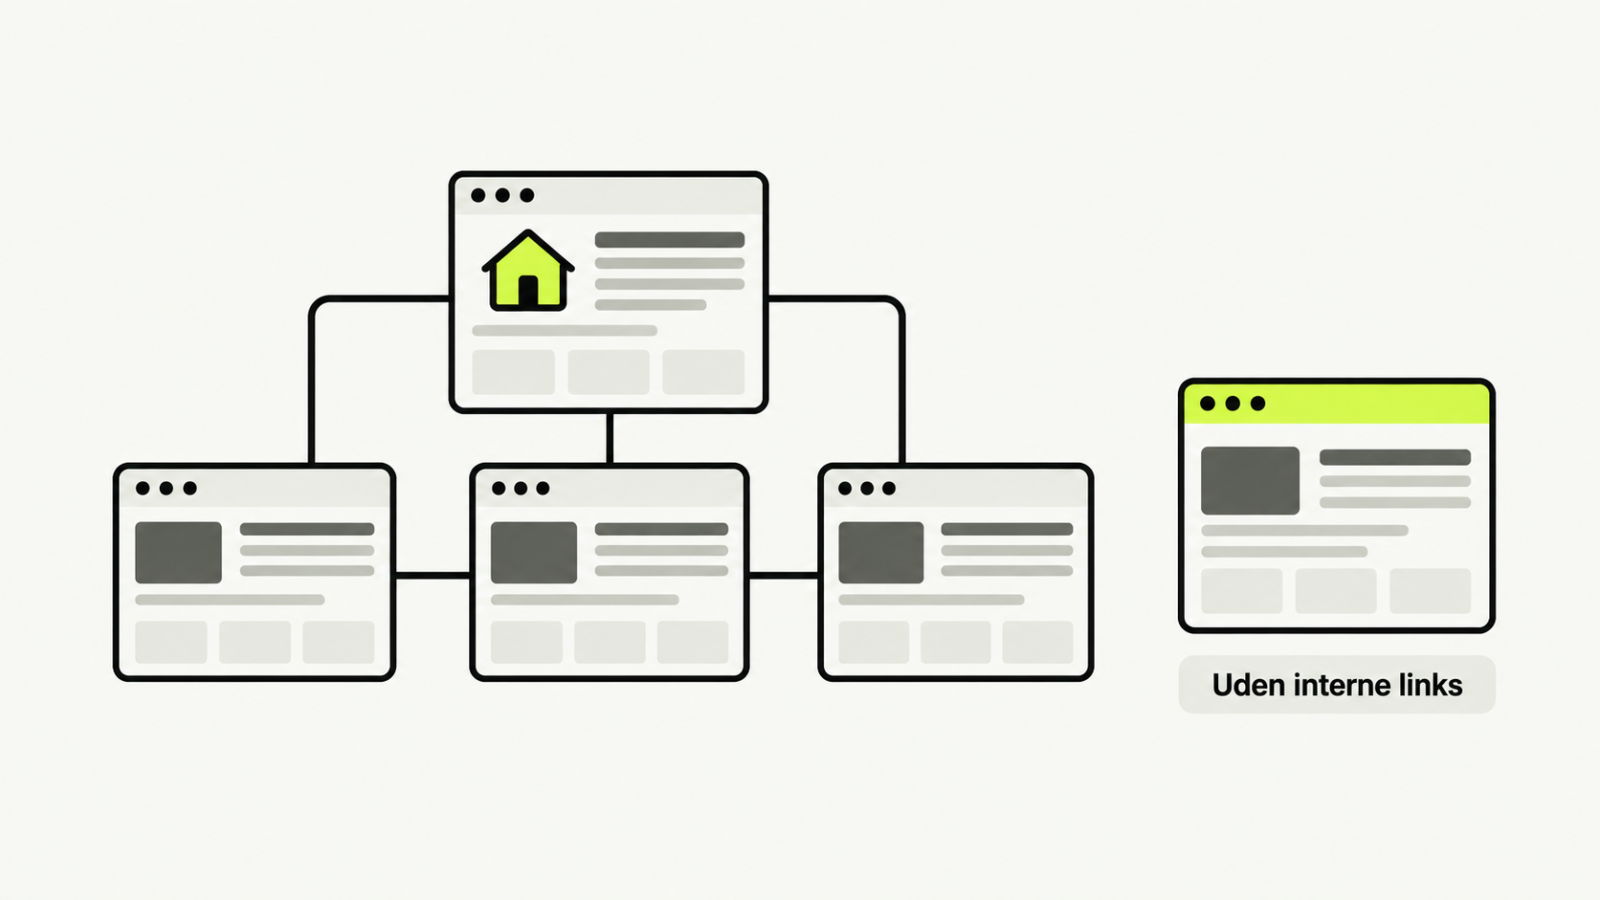
En orphan page, nogle gange kaldt en forældreløs side, er en side på jeres site, som ingen anden side linker til. Ikke en side, der ligger langt nede i menuen. En side, der slet ikke er med. Den kan stadig få besøg fra søgning, annoncer eller eksterne links, men den mangler en intern vej ind fra andre sider.
Hvor et link skal sidde, når siden skal findes, står i intern linkbuilding. Her er det siden, der mangler linket.
En side, ingen anden side peger på
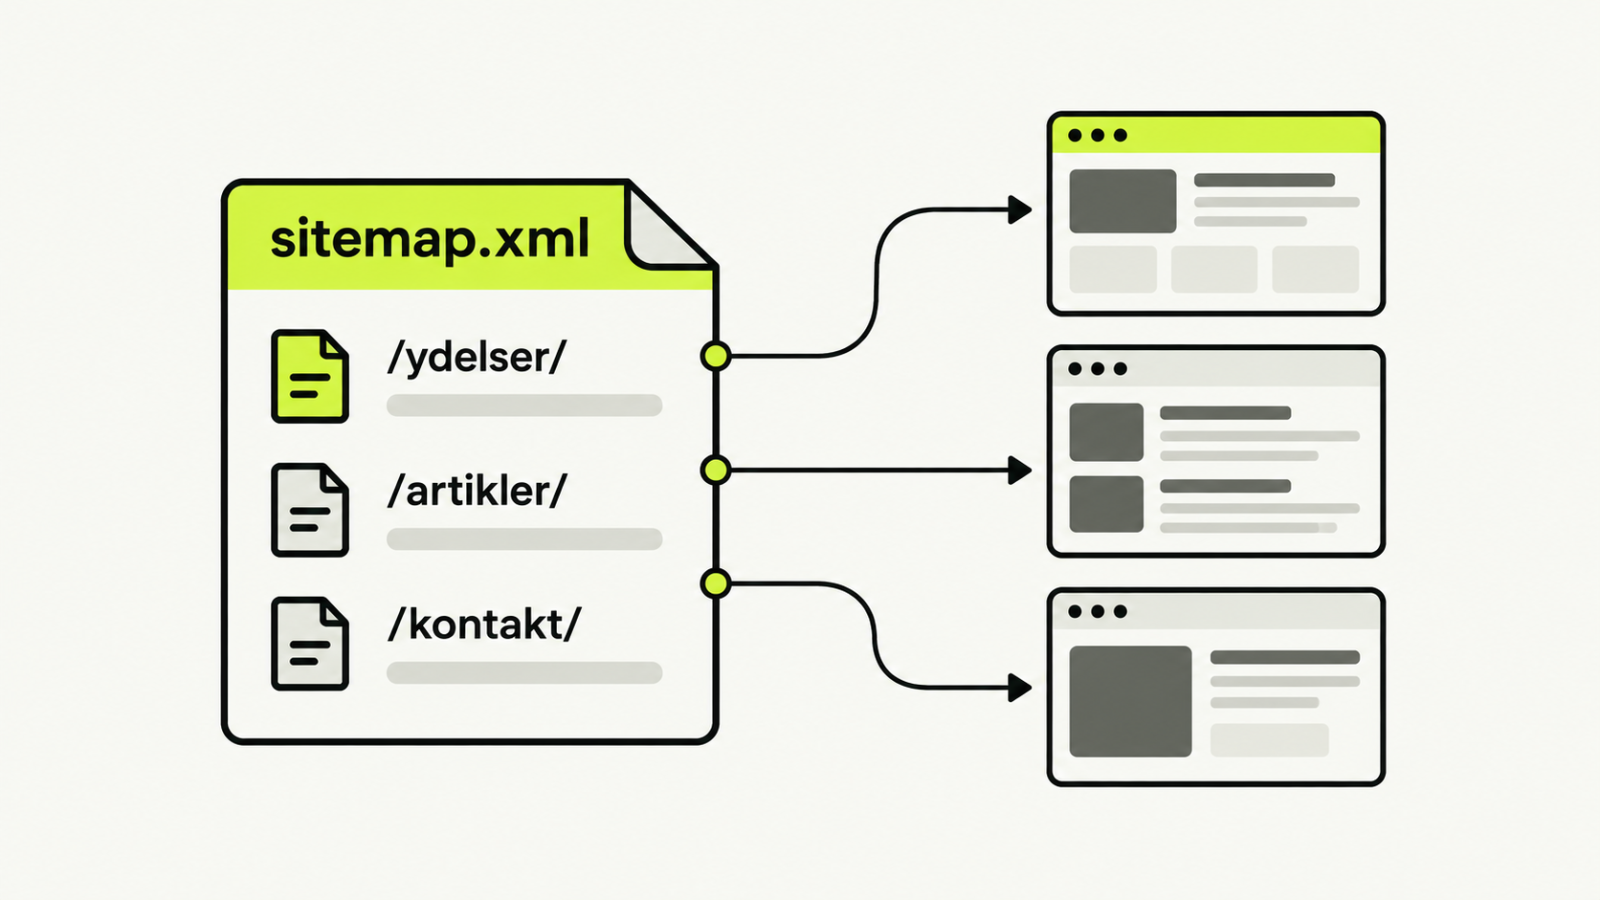
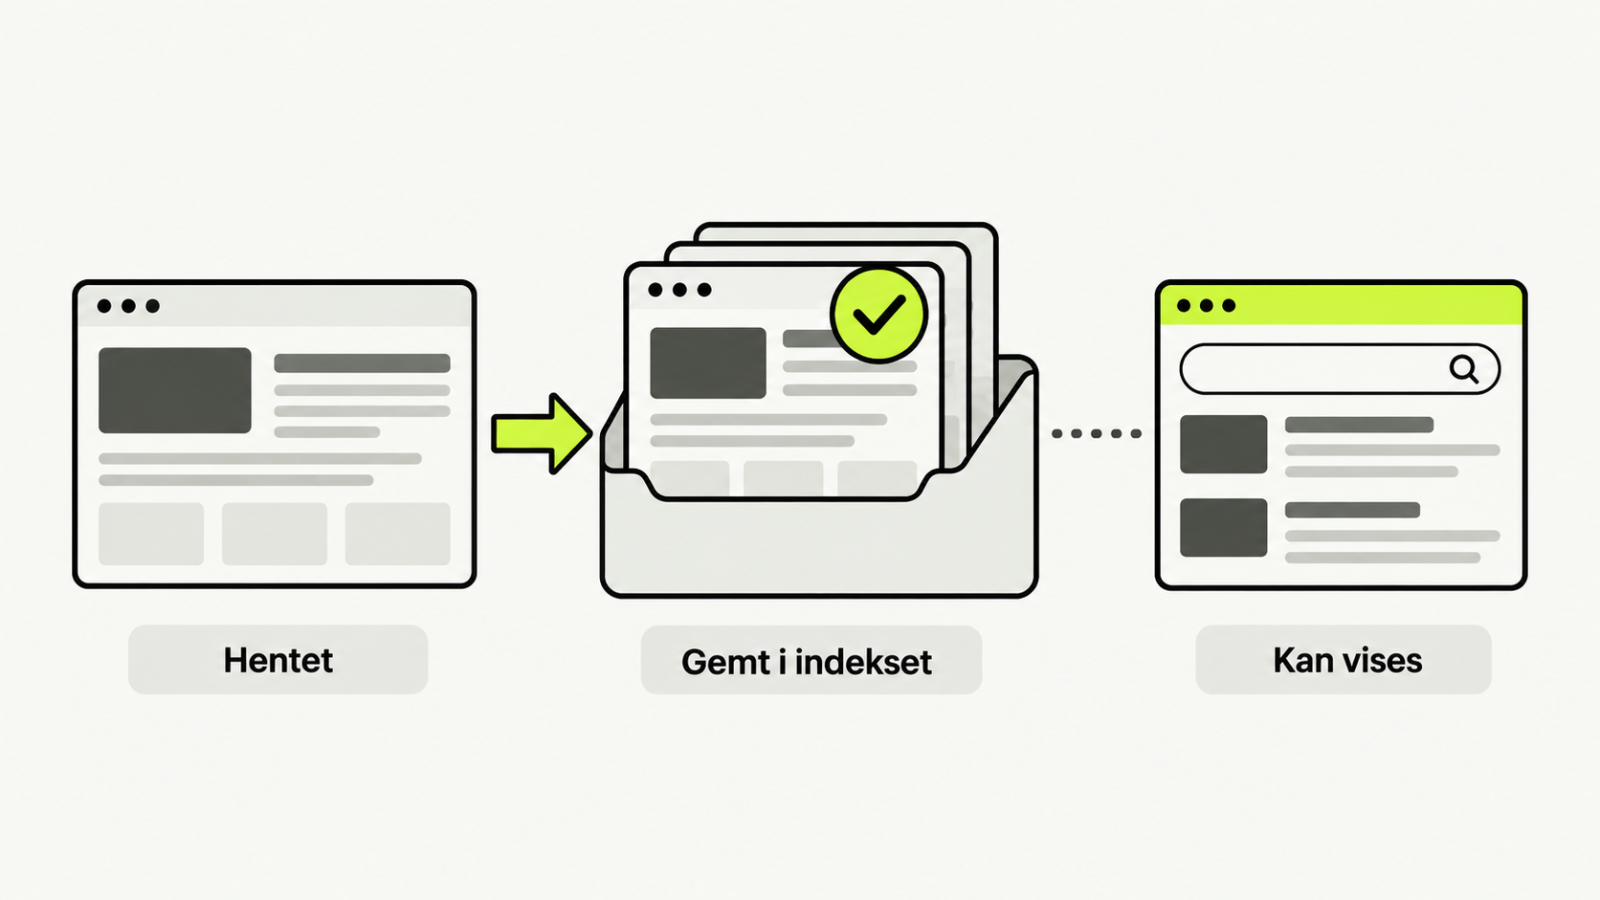
Google finder de fleste sider ved at følge links. Et internt link er den vej, I selv har lagt. Uden den vej kan adressen stadig være kendt, fordi den ligger i et XML-sitemap, eller fordi et andet site linker til den. Siden er bare ikke en del af den struktur, I har bygget.
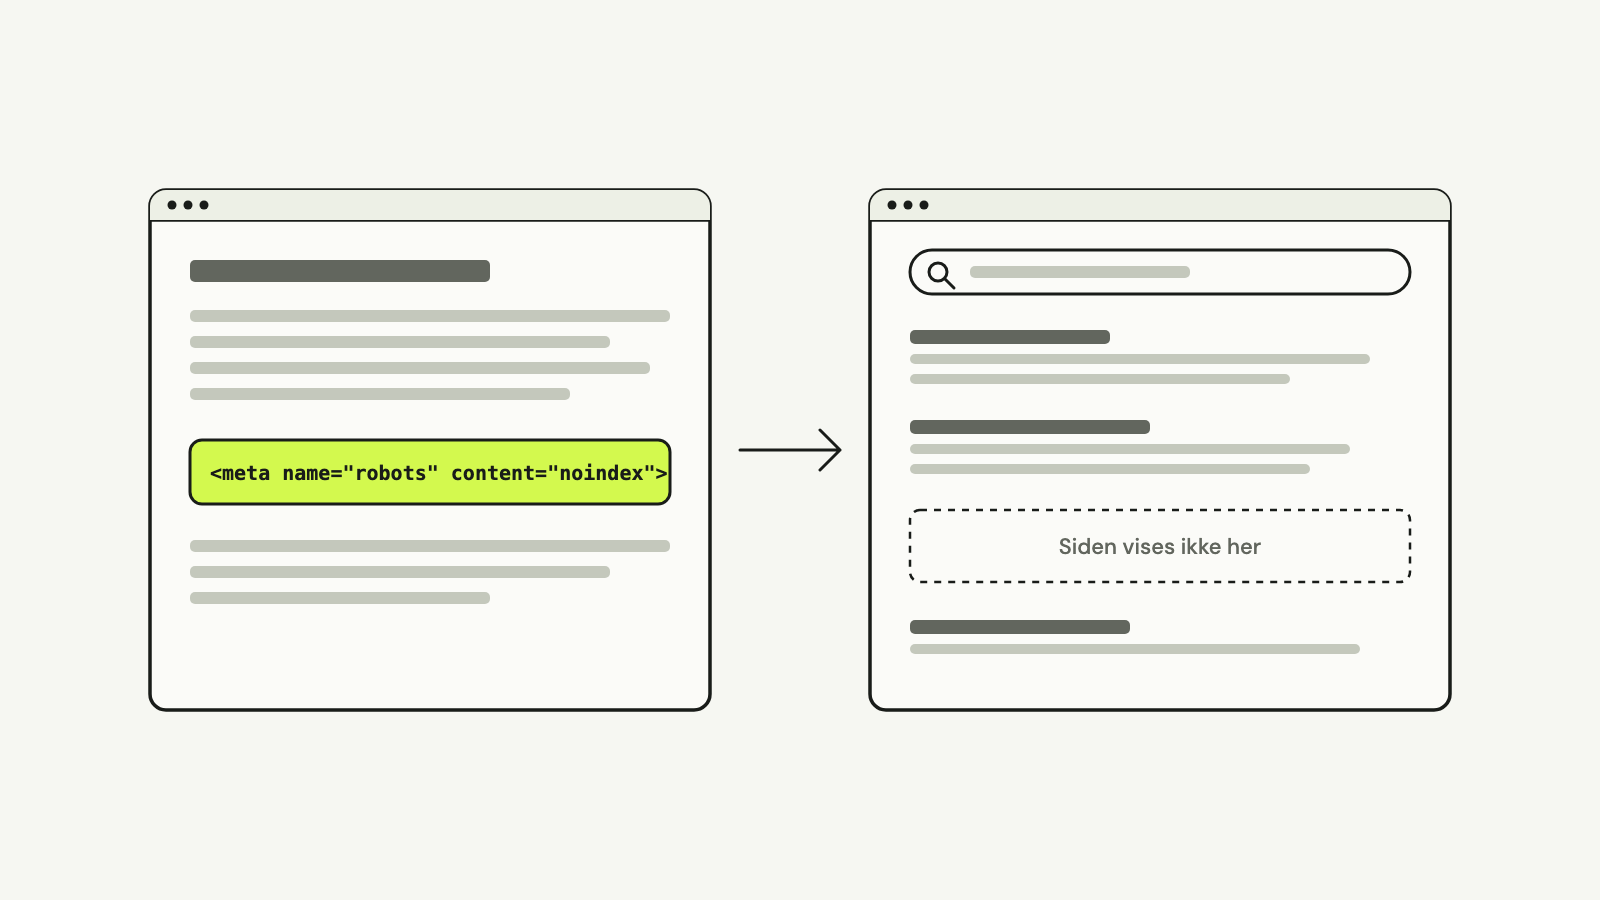
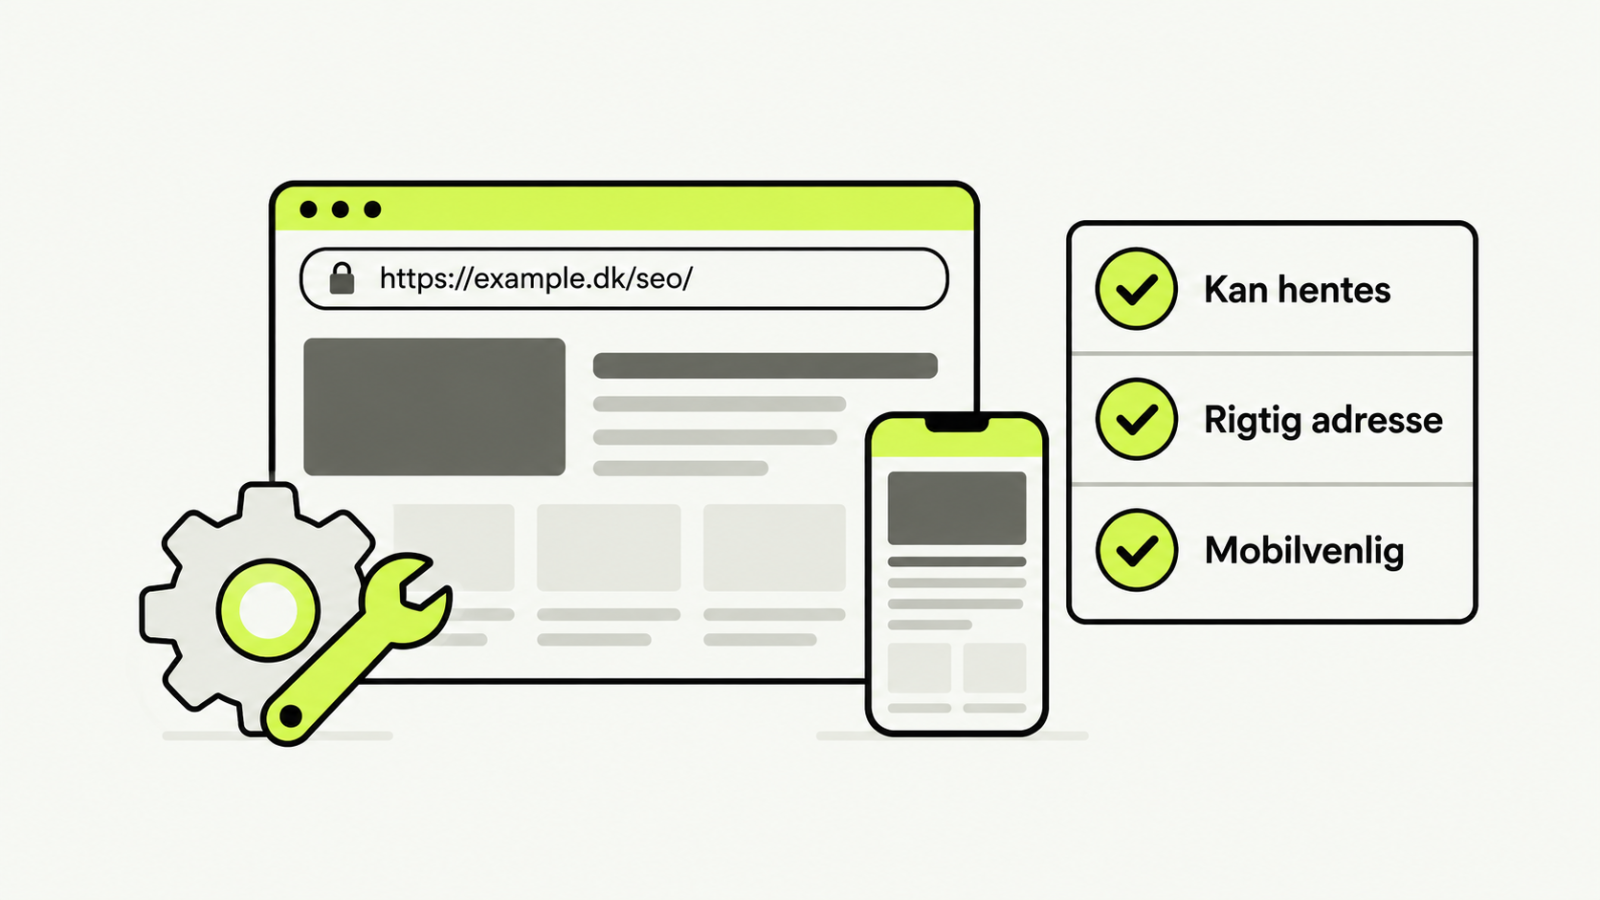
Det er ikke det samme som en side, I har bedt Google om ikke at vise. Noindex, en blokering i robots.txt og en side, der kræver login, er stopklodser. De står i teknisk SEO. En orphan page kan være åben og alligevel usynlig fra forsiden, fordi ingen sætning peger på den.
En kampagneside, der kun skal rammes fra en annonce, og en tak-side efter en formular, må gerne mangle et link i teksten. Det kan være et bevidst valg. Om siden skal indekseres, afhænger af dens formål; annoncetrafik betyder ikke automatisk, at den skal have noindex. En artikel, I har skrevet for at blive fundet, er derimod ikke et bevidst valg.
De opstår, når siden aldrig bliver sat ind
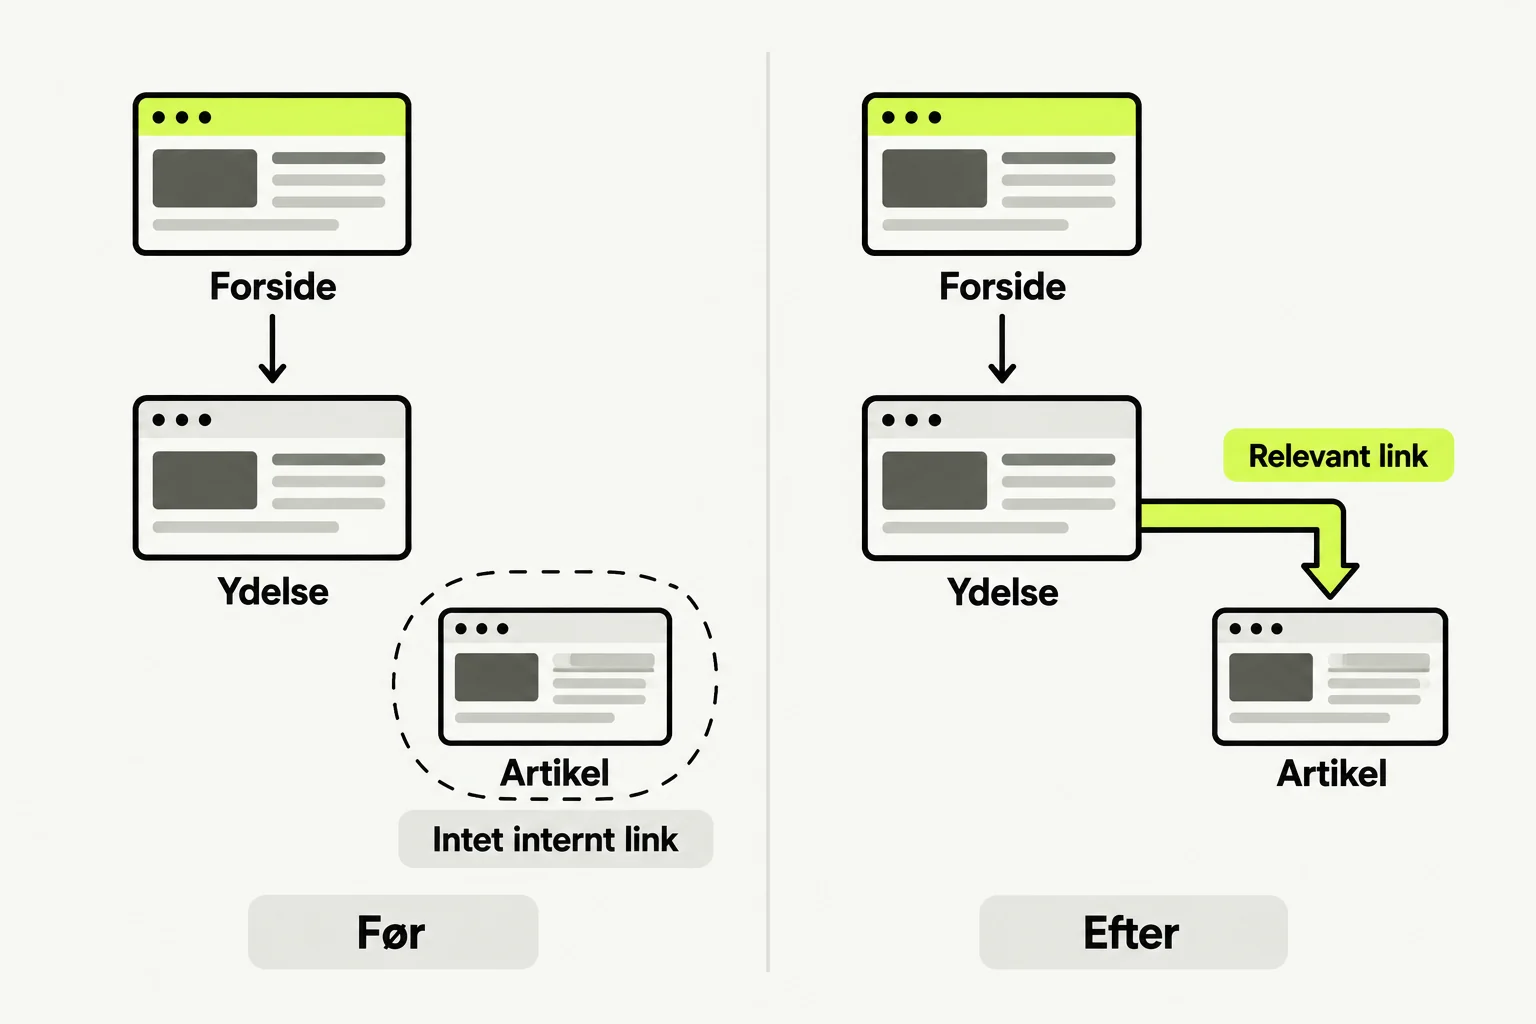
Den nye artikel bliver publiceret, og ingen opdaterer den side, den skulle hænge på. Menuen bliver bygget om, og en underside ryger ud, uden at teksten et andet sted tager over. En landingsside bliver lavet til et udsendt link og bliver aldrig en del af sitet bagefter.
Det sker også, når en adresse flyttes, og den nye side kun ligger i sitemapet. Den gamle adresse skal sende videre. Den nye skal have et link. Ellers har I byttet en adresse ud med en, ingen side peger på. Reglen for flytningen står i omdirigering.
Find dem ved at sammenligne to lister
En crawl følger links fra forsiden og ud. Den liste er de sider, I kan nå. En helt isoleret side mangler derfor på listen. Derfor finder I den ikke ved kun at kigge på crawlen.
Den anden liste er de adresser, I gerne vil have med: sitemapet, og de adresser, Search Console allerede har set. Ligger en adresse dér, og crawlen aldrig nåede den, er den en kandidat.
Læs siden, før I gør noget. Nogle skal have et link. Nogle er den samme tekst som en side, I allerede har, og skal lægges sammen. Nogle skulle aldrig have været en adresse.
Link, flyt eller fjern
Skal siden findes, så link til den fra en sætning, der allerede handler om den. Ikke fra en anden orphan page, og ikke ved at lægge alle glemte sider i footeren. Footer- og menulinks er også interne links og kan gøre sider tilgængelige. Et relevant link i brødteksten giver desuden læseren en forklaring på, hvorfor siden er værd at åbne.
Hører indholdet hjemme på en side, der allerede findes, så læg det dér og send den gamle adresse videre med en 301. To sider med samme tekst er duplicate content, også når den ene ingen links har.
Skal siden blive liggende, men ikke vises i søgning, så sæt noindex. Det er ofte relevant for tak-sider; en kampagneside vurderes ud fra sit konkrete formål. Skal den væk, så fjern den. Har en fjernet side en reel afløser, kan den gamle adresse omdirigeres dertil, ikke til forsiden. Uden relevant afløser er 404 eller 410 normalt mere retvisende.
En enkel kontrol med tre datakilder
Google Search Central anbefaler, at hver side, der betyder noget for jer, har et link fra mindst én anden side på sitet. Samme side forklarer, at Google som regel kun kan følge et link, når det er et <a>-element med en href. En menu, der kun åbner sider via JavaScript-klik, tæller derfor ikke nødvendigvis som en vej ind. Google beskriver samtidig i sin gennemgang af søgning, at URL’er også kan opdages via eksempelvis sitemaps. En orphan page kan derfor godt være indekseret.
- Eksportér de publicerede URL’er fra CMS’et. Medtag også gamle landingssider, der stadig skal vurderes.
- Crawl fra forsiden. Indlæser værktøjet også sitemapet, skal I bruge dets særskilte rapport over adresser, der kun blev fundet i sitemapet. Ellers skjuler crawlen måske den manglende interne forbindelse. Screaming Frogs vejledning beskriver metoden: crawl de interne links, hent adresser fra XML-sitemaps, Google Analytics og Search Console, og kør en crawlanalyse bagefter, som udskiller de adresser, crawlen ikke nåede via links.
- Sammenlign listerne, og brug sitemap, analytics og Search Console som ekstra spor. Ingen af dem er nødvendigvis en komplet URL-fortegnelse.
- Undersøg kandidater manuelt: En crawler kan overse JavaScript-navigation eller sider bag adgangsbegrænsninger.
- Notér beslutningen for hver side: relevant link, sammenlægning, noindex eller fjernelse. Crawl igen for at kontrollere ændringen.
Hos os er orphan pages en del af SEO-forløbet, når de interne links skal sættes, så de sider, der skal findes, også kan nås fra sitet. Sider uden interne links finder vi med en crawl i arbejdet med teknisk SEO.
Kilder
- Google Search Central, Link best practices for Google, developers.google.com.
- Google Search Central, In-depth guide to how Google Search works, developers.google.com.
- Screaming Frog, How To Find Orphan Pages, screamingfrog.co.uk.