Indhold
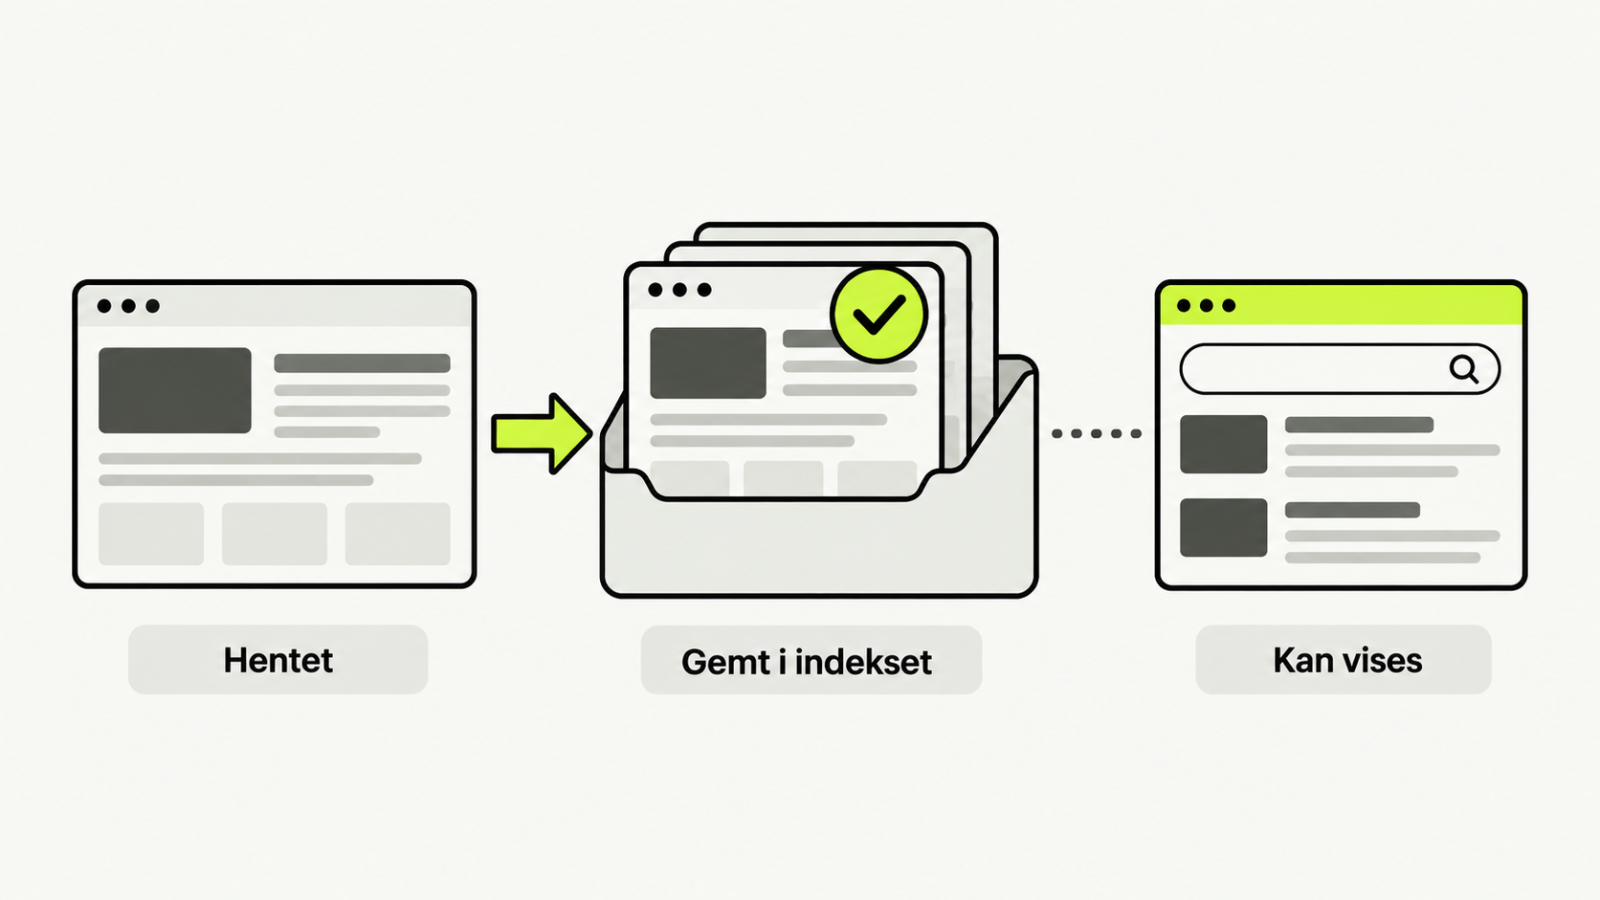
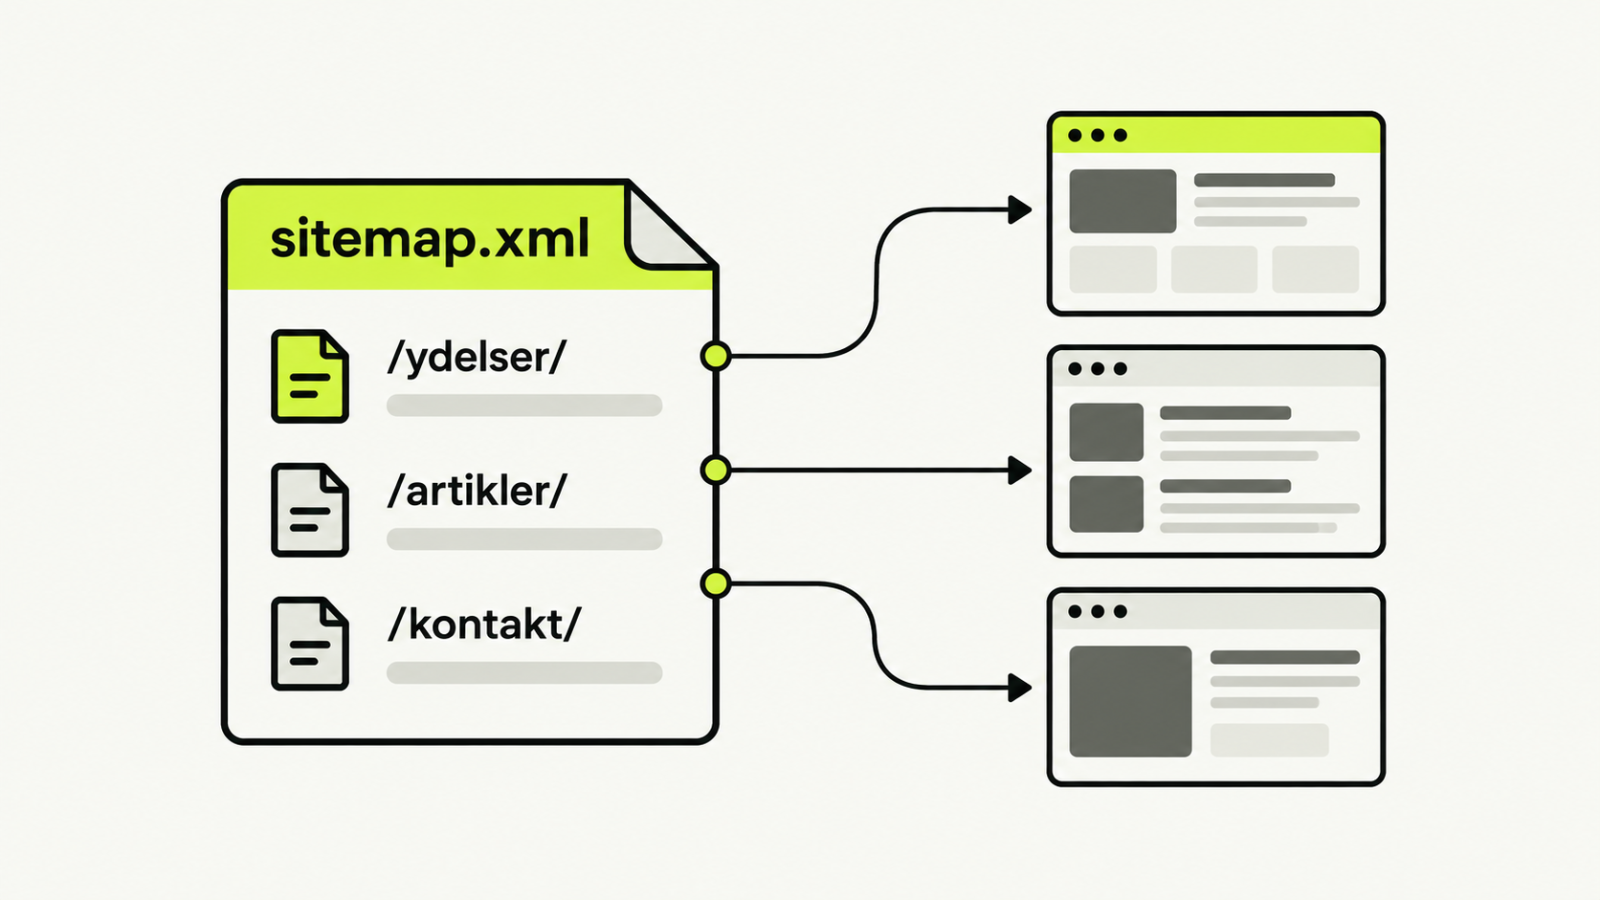
Et XML-sitemap er en fil med de adresser, I gerne vil have fundet. Google læser den for at kende adresserne. Den lægger dem ikke i indekset. Indeksering er, at Google har gemt siden og kan vise den.
En HTML-oversigt med links hjælper besøgende og kan også bruges af Google til at finde sider. XML-sitemapet er en supplerende, struktureret liste.
Et nyt site med få links fra andre sites har mest brug for filen. Google har færre andre veje ind. Det samme gælder et stort site, hvor det er svært at sikre, at hver ny side har et link.
Et lille site kan ofte undvære den. Google Search Central kalder et site lille, når det har omkring 500 sider eller færre, I vil have med i søgningen, og de vigtige sider kan nås fra forsiden.
Eksempel
Hver adresse står i et url-element. loc er selve adressen. Den skal være den fulde, med https, den samme som canonical-tagget og de interne links:
<url>
  <loc>https://adbull.dk/ydelser/seo/</loc>
</url>
lastmod er datoen, siden sidst blev ændret væsentligt. Google skrev i 2023, at lastmod bruges til at planlægge ny crawl, men kun når datoen stemmer med virkeligheden. En dato, der skifter hver nat, uden at teksten er ændret, holder Google op med at stole på. En ændring i footer eller sidebar kræver ikke ny dato; ny hovedtekst, nye strukturerede data eller ændrede links gør. priority og changefreq læser Google ikke.
Hvad der skal med
Ydelsessider, artikler og de kategorier, I vil findes på. Side 2 af en oversigt hører med, når den peger på sig selv. Den viser andre sider end side 1.
Et tag med ét indlæg er endnu ikke en side, I vil findes på. Lad det vente, til det har sit eget svar.
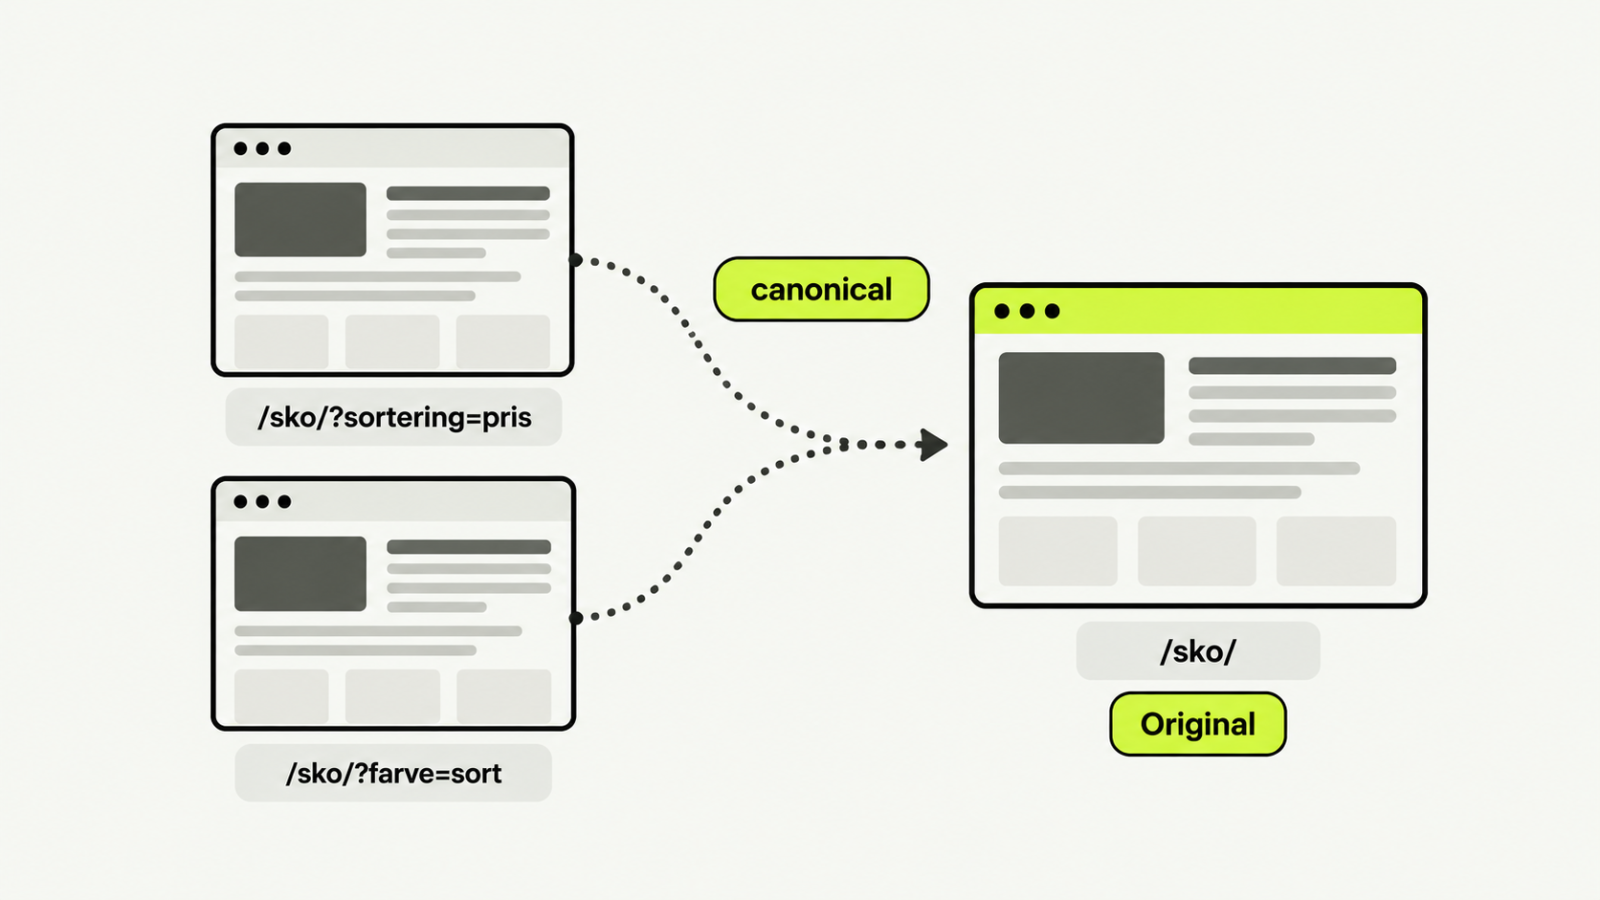
Adressen på listen skal være den, canonical-tagget peger på. Peger tagget på /sko/, er det /sko/, der står i filen. Ikke /sko/?farve=sort.
Hvad der skal holdes ude
Dubletter fra filtre, sortering og sporingsparametre skal normalt ikke med. En filtreret side med selvstændigt indhold og en søgeopgave kan derimod være en relevant canonical URL. En omdirigering skal heller ikke med. Den gamle adresse svarer ikke længere, og listen skal ikke bede Google om at hente den.
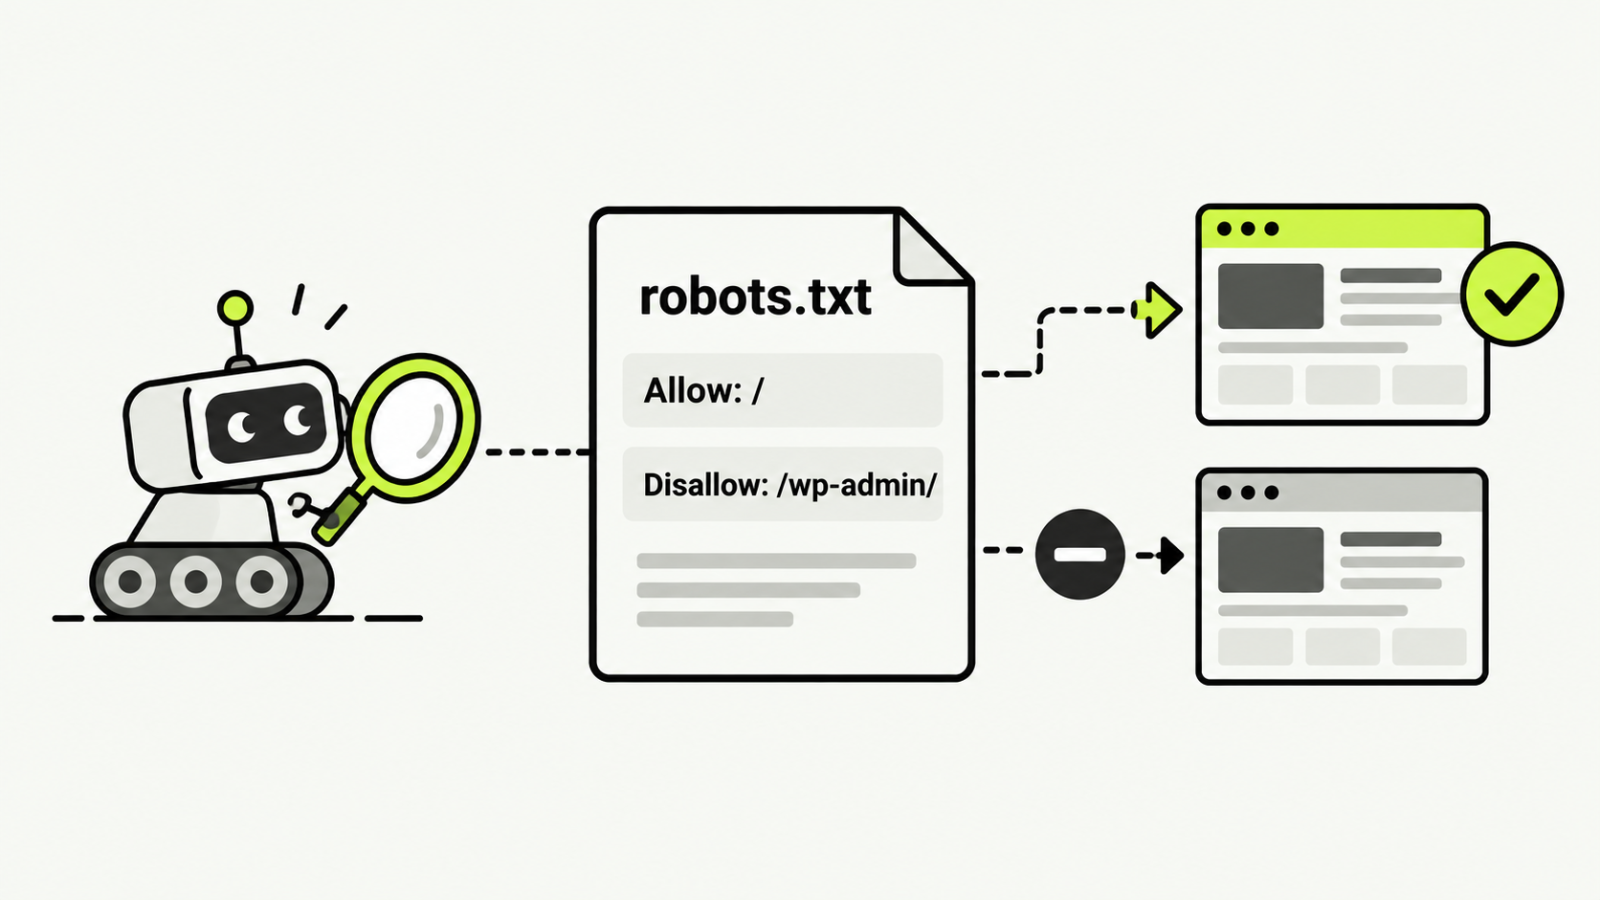
En side med noindex, en 404 og en adresse, robots.txt blokerer, hører ikke hjemme på listen. Teknisk SEO holder dem ude. Listen må ikke pege på dem bagefter.
At holde en adresse ude af filen gør den ikke usynlig. Kan Google følge et link dertil, kan den stadig gemme siden. En kvitteringsside efter en tilmelding skal have noindex. Ellers kan den blive vist, selv om den ikke står på listen.
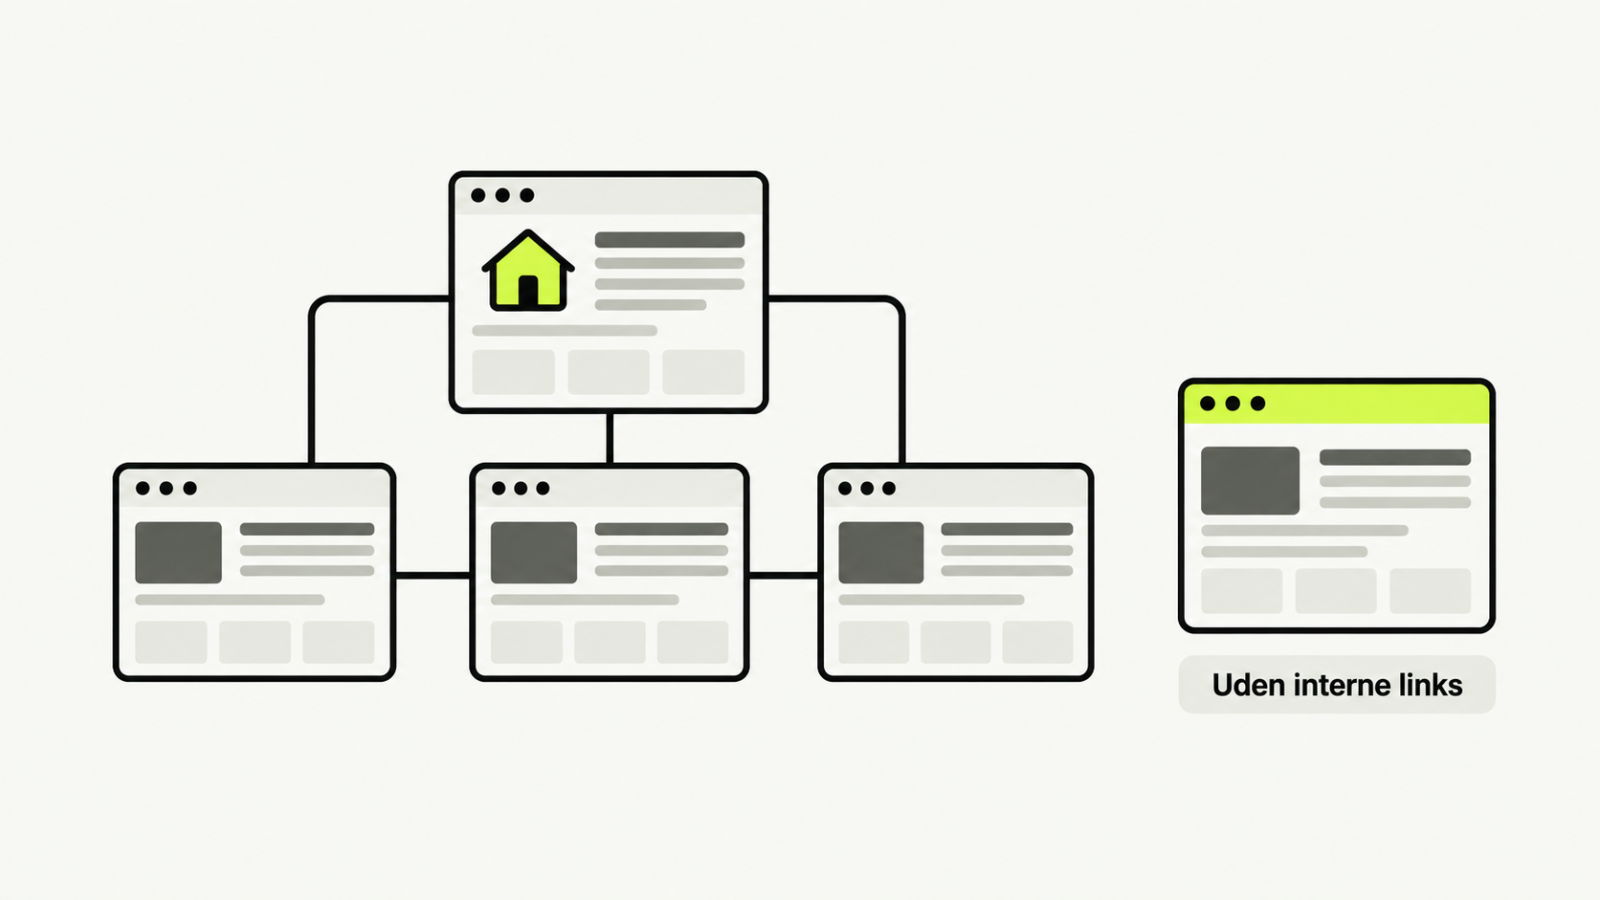
En adresse, ingen side linker til, bliver ikke en del af sitet, fordi den står i filen. Det er en orphan page.
Når én fil ikke rækker
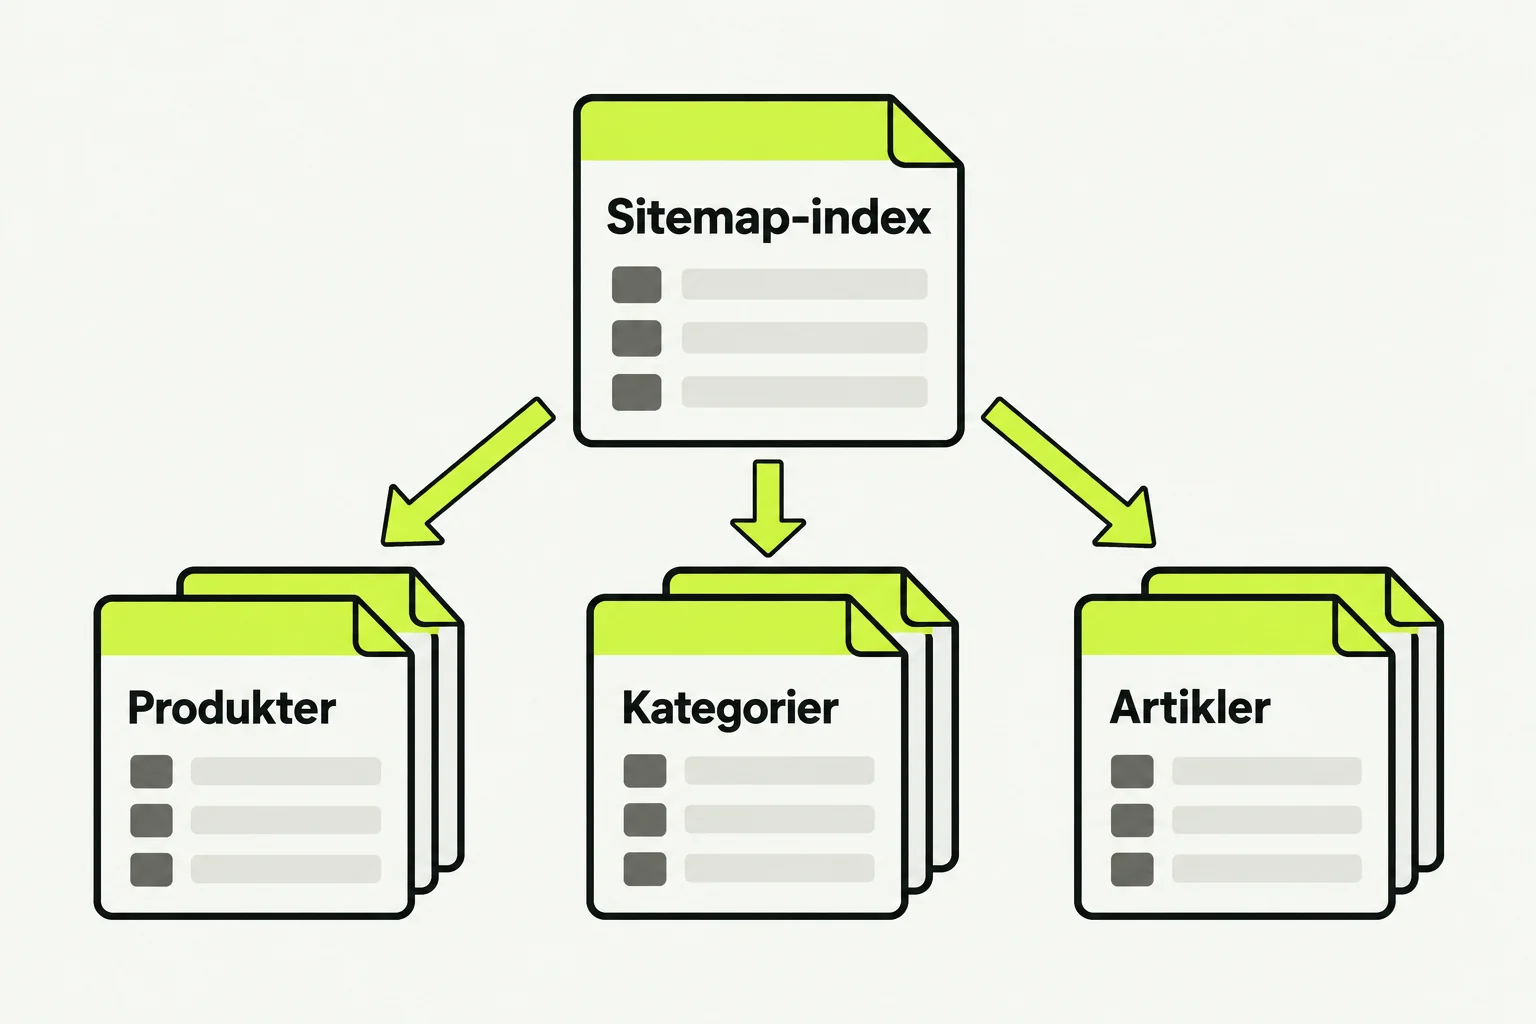
Google skriver, at en fil højst må rumme 50.000 URL’er og fylde 50 MB ukomprimeret. Overskrides en af grænserne, skal den deles. En webshop med flere lister samler dem i et sitemap-index. Det er en fil, der peger på de andre: kategorier i én, produkter i en anden, artikler i en tredje. Google læser indexet og finder resten.
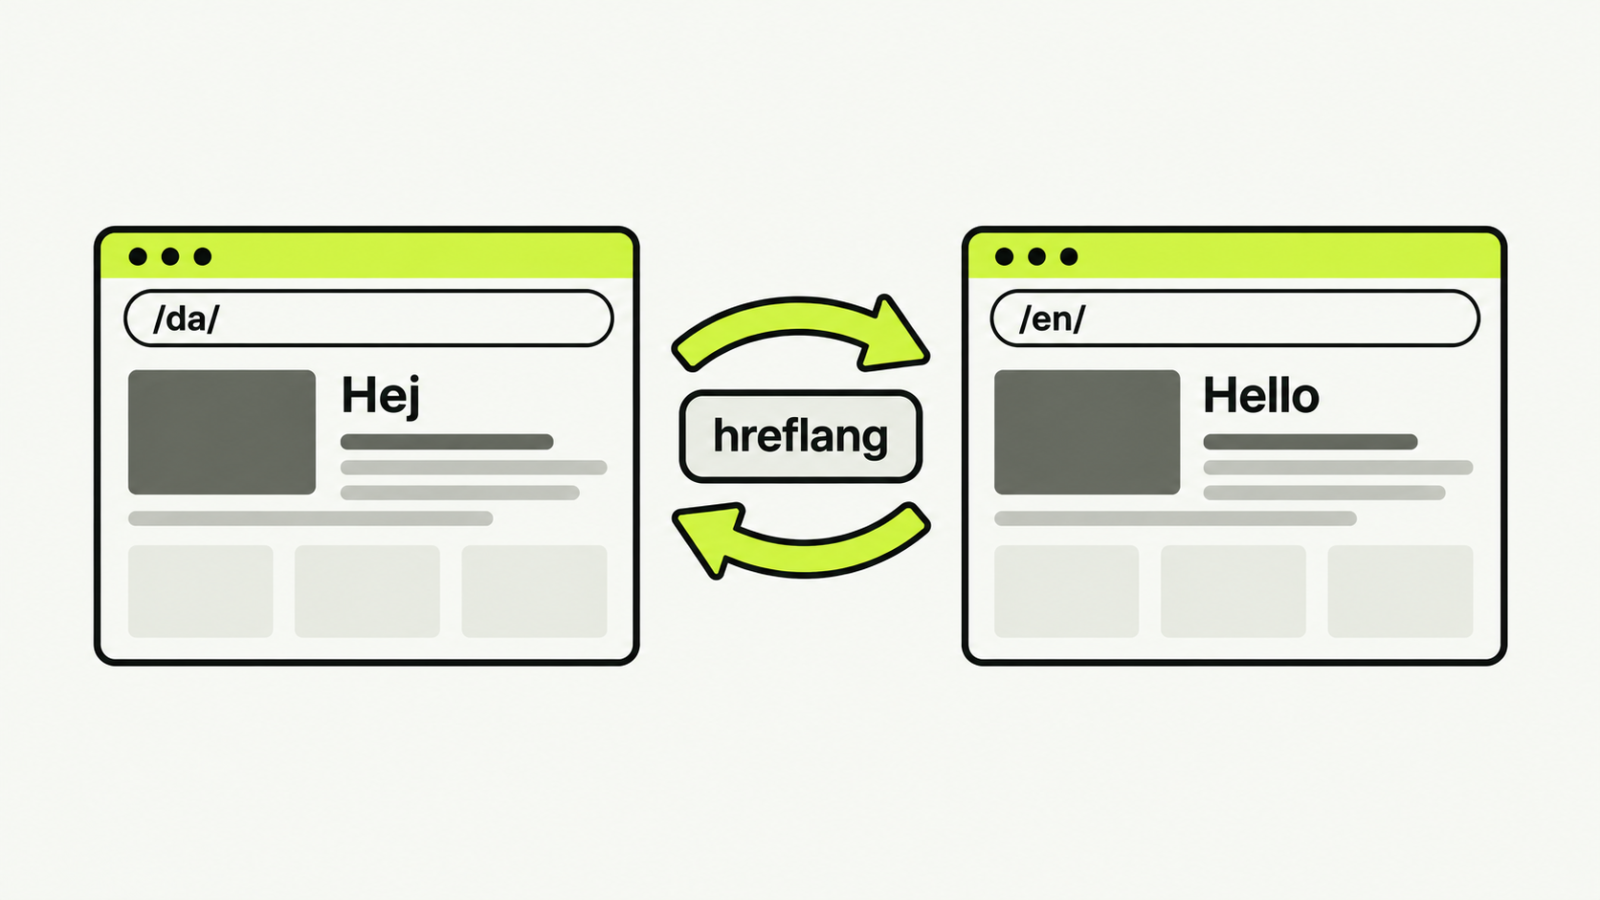
Billeder i HTML kan findes ved crawl af siden. Et sitemap kun til billeder hører til i image SEO, når billedet ikke står i HTML’en. hreflang kan stå i XML-filen. Hvilken adresse der hører til hvilket sprog, er flersproget SEO.
En video kan stå i filen med længde og aldersgrænse. En nyhed kan stå med titel og udgivelsesdato. Google bruger de oplysninger, når indholdet skal vises i video- og nyhedsresultaterne.
Hvor Google finder filen
To steder. En linje i robots.txt, Sitemap: https://adbull.dk/sitemap.xml, og den samme fil indsendt i Search Console. De to skal pege på den samme adresse. Den gamle metode med at “pinge” Google med sitemapets adresse er udfaset. Google meddelte i juni 2023, at endpointet ville holde op med at virke, og at plugins, der stadig pinger, ikke gør skade, men heller ikke gør noget.
WordPress har et indbygget sitemap på /wp-sitemap.xml, når funktionen er aktiv. SEO-plugins kan erstatte det med eksempelvis /sitemap_index.xml. Find den fil, installationen faktisk genererer, frem for at antage en bestemt adresse. Filen skal opdateres, når en side udgives eller fjernes.
I Search Console kan I se, hvor mange adresser der er sendt ind, og hvor mange der er indekseret. En forskel er ikke i sig selv bevis for en sitemapfejl. Google kan kende en adresse uden at indeksere den, eksempelvis ved dubletter, noindex eller en anden valgt canonical. Tjek også en ydelsesside, et filter og en omdirigering. Ydelsessiden skal være med. Filteret og den gamle adresse skal ikke.
Et komplet, minimalt sitemap
Google Search Central viser kravene til XML-formatet. Et selvstændigt dokument skal blandt andet have rod-element og namespace; et enkelt url-element er kun et udsnit.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/ydelser/seo/</loc>
  </url>
</urlset>
Brug lastmod til væsentlige ændringer i indholdet, når datoen er pålidelig. Sitemapet er et hint om adresser, ikke en ordre om indeksering.
Kontrollér filen og siderne hver for sig
- Åbn sitemapet og kontrollér, at det svarer uden serverfejl og indeholder de forventede fulde adresser.
- Find en vigtig ydelsesside. Kontrollér, at den svarer 200, kan indekseres og har den ønskede canonical.
- Indsend filen i Search Consoles sitemaprapport. En vellykket indlæsning betyder, at filen er læst uden fejl. Google skriver, at der ikke er nogen garanti for, at adresserne bliver crawlet eller indekseret. Filtrér sideindekseringsrapporten på sitemapet for at se, hvor mange der er med.
- Undersøg fravalgte URL’er i sideindekseringsrapporten og URL-inspektion. Ret årsagen på siden frem for at indsende samme liste igen og igen.
Hos os er XML-sitemapet en del af SEO-forløbet, når listen og de sider, der skal findes, ikke er de samme. Sitemap, indeksering og crawl gennemgår vi samlet under teknisk SEO.
Kilder
- Google Search Central, What is a sitemap, developers.google.com.
- Google Search Central, Build and submit a sitemap, developers.google.com.
- Google Search Central Blog, Sitemaps ping endpoint is going away, juni 2023, developers.google.com.
- Search Console Help, Sitemaps report, support.google.com.